Code
# Carregando o tidyverse
library(tidyverse)# Carregando o tidyverse
library(tidyverse)Esses dados são cortesia do Dr. John Schorling, Departamento de Medicina, Faculdade de Medicina da Universidade da Virgínia. Os dados consistem em 19 variáveis em 403 indivíduos de 1046 indivíduos que foram entrevistados em um estudo para compreender a prevalência de obesidade, diabetes e outros fatores de risco cardiovascular na Virgínia central para afro-americanos. De acordo com John Hong, Diabetes Mellitus Tipo II (DM II) está associado à obesidade e a relação entre a estatura / quadril pode ser um preditor de diabetes e doenças cardíacas. DM II também também está associado à hipertensão.
Para fins desse estudo iremos considerar um nível de hemoglobina glicosilada acima de 7 como um sinal positivo de diabetes.
Para mais informações sobre este estudo, consulte Willems JP, Saunders JT, DE Hunt, JB Schorling: Prevalence of coronary heart disease risk factors among rural blacks: A community-based study. Southern Medical Journal 90:814-820; 1997 & Schorling JB, Roach J, Siegel M , Baturka N, Hunt DE, Guterbock TM , Stewart HL: A trial cessation interventions for rural African Americans. Preventive Medicine26:92-101; 1997.
Esses banco de dados pode ser obtido no endereço abaixo: https://hbiostat.org/data/
# Lendo os dados com a função read.csv
df <- read.csv("https://hbiostat.org/data/repo/diabetes.csv")| Variável | Tipo | Descrição |
|---|---|---|
id |
Numérica | Identificador único do paciente. |
chol |
Numérica | Nível de colesterol total (mg/dL). |
stab.glu |
Numérica | Nível de glicose estável (mg/dL). |
hdl |
Numérica | Nível de colesterol HDL (mg/dL). |
ratio |
Numérica | Razão entre colesterol total e HDL. |
glyhb |
Numérica | Nível de hemoglobina glicada (%). |
location |
Categórica | Localização do paciente (Buckingham ou outra localidade). |
age |
Numérica | Idade do paciente (anos). |
gender |
Categórica | Gênero do paciente (male ou female). |
height |
Numérica | Altura do paciente (polegadas). |
weight |
Numérica | Peso do paciente (libras). |
frame |
Categórica | Estrutura corporal (small, medium, large). |
bp.1s |
Numérica | Pressão arterial sistólica na primeira leitura (mm Hg). |
bp.1d |
Numérica | Pressão arterial diastólica na primeira leitura (mm Hg). |
bp.2s |
Numérica | Pressão arterial sistólica na segunda leitura (mm Hg). |
bp.2d |
Numérica | Pressão arterial diastólica na segunda leitura (mm Hg). |
waist |
Numérica | Circunferência da cintura (polegadas). |
hip |
Numérica | Circunferência do quadril (polegadas). |
time.ppn |
Numérica | Tempo desde a última ingestão de comida até a coleta de sangue (minutos). |
Para fins desse estudo iremos considerar um nível de hemoglobina glicosilada acima de 7 como um sinal positivo de diabetes.
A hemoglobina glicosilada está armazenada na variável glyhb.
Usaremos a função ifelse() para criar essa variável, com a seguinte definição:
0 significando não diabéticos. 1 significando diabéticos.
# Criando a variável categórica diabetes
df$diabetes <- ifelse(df$glyhb<=7, 0, 1 )# Verificando o tipo de dado da variável recem criada diabetes:
class(df$diabetes)[1] "numeric"# Transformando a variável diabetes em categórica com a função as.factor()
df$diabetes <- as.factor(df$diabetes)# Verificando o tipo de dado da variável diabetes depois da transformação em factor
class(df$diabetes)[1] "factor"# Contando os casos de diabéticos (lembre-se que 1 indica os diabéticos)
table(df$diabetes)
  0   1
330 60 # Criando uma variável categórica a partir da idade
df$age_cat <- cut(df$age,
breaks=c(-Inf, 44, 64, 74, Inf),
labels=c("<45","45-64","65-74", "75+"))# Mostrando lado a lado a variável age e a age_cat (categórica)
df |> select(age, age_cat) |> head() age age_cat
1 46 45-64
2 29 <45
3 58 45-64
4 67 65-74
5 64 45-64
6 34 <45Por padrão, os intervalos são abertos à esquerda e fechados à direita, como em (7,9]. Para configurar os intervalos como fechados à esquerda e abertos à direita, como [7,9), use right=FALSE.
# Crie aqui um código usando a função table() para mostrar os sexos (gender) em cada grupo etário (age_cat)
table(df$gender, df$age_cat)
         <45 45-64 65-74 75+
  female 126    75    21  12
  male    74    64    20  11
Dica: table(df$gender, df$age_cat)
Como este é um conjunto de dados dos EUA, a altura está em polegadas e o peso está em libras. No entanto, nem a altura nem o peso são particularmente úteis por si só, por isso é comum combiná-los no índice de massa corporal (IMC), que é o peso dividido pelo quadrado da altura; ambas as medidas precisam estar em unidades SI, ou seja, quilogramas e metros, então precisamos converter as unidades de medida.
# Transformando as unidades de medida da altura para metros
df$altura <- df$height*0.0254# Transforme agora as unidades de medida do peso em kg: multiplique o peso em libras por 0.453592
# crie para isso uma nova variável chamada peso.
df$peso <- df$weight*0.453592Dica: df$peso <- df$weight*0.453592
df$imc <- df$peso/(df$altura^2)Tente entender o que cada linha desse código abaixo faz ao plotar o gráfico. Não se preocupe com os detalhes, apenas a idéia geral de cada linha. tente eliminar alguma linha e plote novamente o gráfico para verificar o que acontece.
ggplot(df)+
  geom_histogram(aes(x=glyhb, fill=diabetes), alpha=0.6, bins = 50, na.rm = TRUE) +
  geom_vline(xintercept = 7, col="red") +
  labs(title="Histograma dos Níveis de Hemoglobina Glicosilada") +
  xlab("Nível de Hemoglobina Glicosilada") +
  ylab("Hemoglobina Glicosilada ") +
  theme_classic()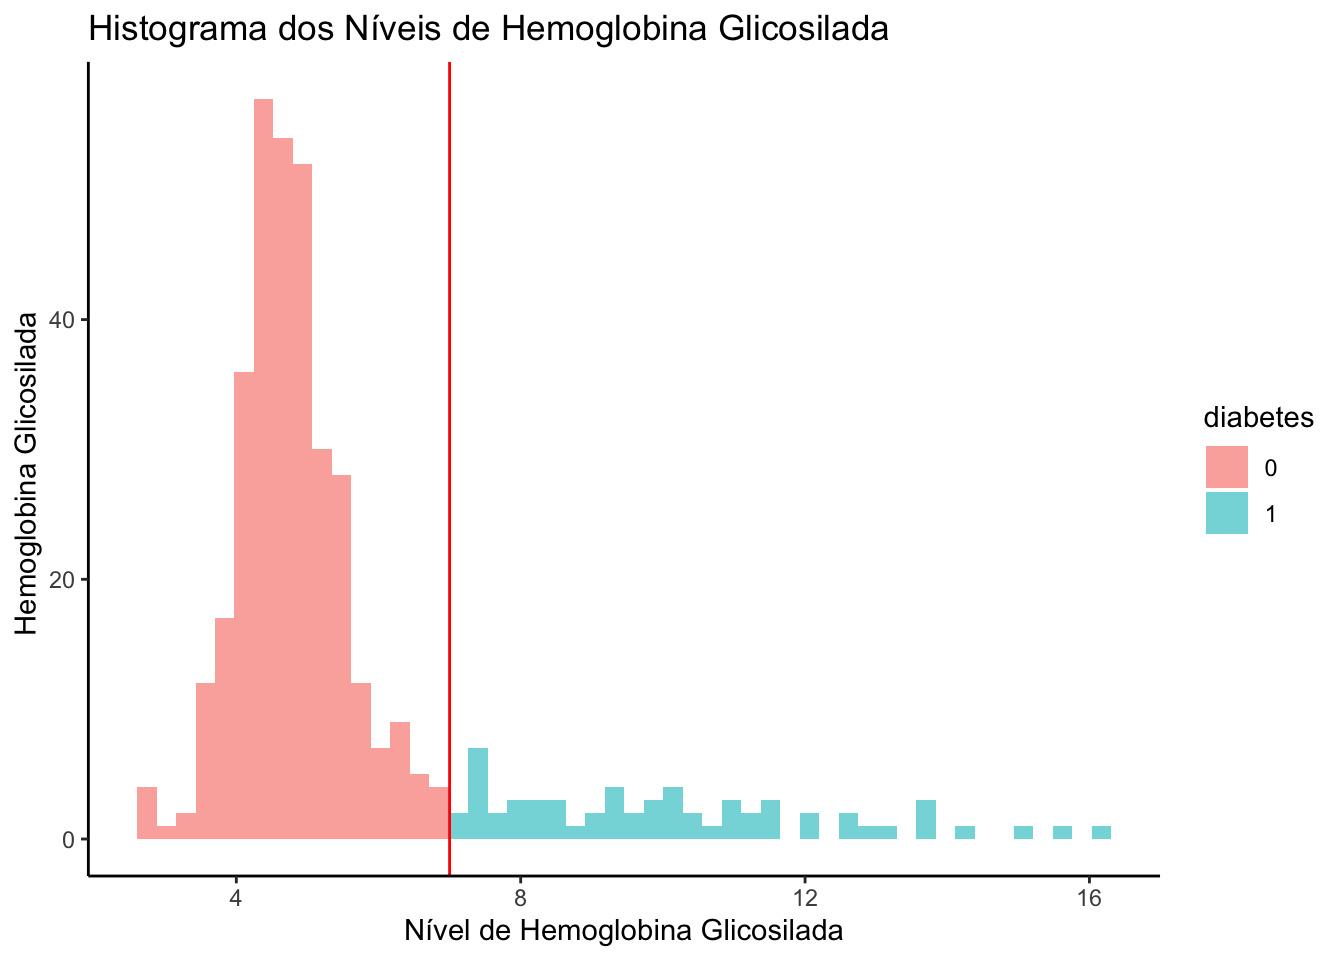
Para fins de exibição e também porque limiares são usados na tomada de decisões clínicas, é útil categorizar algumas variáveis contínuas, mesmo que isso resulte na perda de informações. Por exemplo, é muito comum categorizar o IMC. Uma razão para isso é que as agências de saúde pública podem rastrear o número de pessoas e a proporção da população que são obesas, por exemplo. Rastrear a média ou mediana do IMC da população não fornecerá essa informação. Existem várias maneiras de categorizar o IMC em R. Aqui está uma delas. Vamos supor que queremos grupos para baixo peso [<18.5], normal [18.5-25], sobrepeso [>25 - 30] e obesidade [>30]; uma categoria de obesidade mórbida também existe, mas vamos ignorá-la aqui.
imc_cat <- cut(df$imc,
               breaks=c(-Inf, 18.5, 25, 30, Inf),
labels=c("underweight","normal","overweight", "obese"))# Crie um código para mostrar uma tabela de frequencias da variável imc_cat recém criadaDica: table(imc_cat)
Vamos criar um modelo de regressão logística para a variável diabetes, que foi gerada a partir dos valores de hemoglobina glicada (glyhb). A variável diabetes foi codificada como uma variável binária, onde 0 indica níveis normais de glicose no sangue (definidos por um valor de glyhb menor ou igual a 7) e 1 indica níveis elevados de glicose, sugerindo a presença de diabetes (definido por um valor de glyhb maior que 7).
A regressão logística é uma técnica estatística adequada para modelar variáveis dependentes binárias. Nesse caso, utilizaremos a regressão logística para identificar e quantificar a associação entre a presença de diabetes e outras variáveis explicativas no conjunto de dados. O objetivo é prever a probabilidade de um indivíduo ser diabético (diabetes = 1) com base em variáveis preditoras selecionadas, como idade, gênero, IMC, pressão arterial, entre outras.
Esse modelo será útil não apenas para prever a probabilidade de diabetes, mas também para entender melhor os fatores de risco associados à condição.
O argumento da função family=binomial (link=logit) indica que será usada a função logística e que a variável de desfecho tem apenas duas possibilidades (diabético ou não), por isso foi escolhida a distribuição binomial.
# criando o modelo de regressão logistica
# usando como variável de desfecho a diabetes e nenhuma variáveis independente
model1 <- glm(diabetes ~ 1, data=df, family=binomial (link=logit))

# Mostre o resumo do resultado do modelo de regressão logistica criado acima
summary(model1)
Call:
glm(formula = diabetes ~ 1, family = binomial(link = logit),
    data = df)

Coefficients:
            Estimate Std. Error z value Pr(>|z|)
(Intercept)  -1.7047     0.1403  -12.15   <2e-16 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

(Dispersion parameter for binomial family taken to be 1)

    Null deviance: 334.87  on 389  degrees of freedom
Residual deviance: 334.87  on 389  degrees of freedom
  (13 observations deleted due to missingness)
AIC: 336.87

Number of Fisher Scoring iterations: 3# criando o modelo de regressão logistica
# usando como variável de desfecho a diabetes e como variáveis independentes (preditoras) a cidade
model2 <- glm(diabetes ~ location, data=df, family=binomial (link=logit))
# Mostre o resumo do resultado do modelo de regressão logistica criado acima
summary(model2)
Call:
glm(formula = diabetes ~ location, family = binomial(link = logit),
    data = df)

Coefficients:
               Estimate Std. Error z value Pr(>|z|)
(Intercept)     -1.6349     0.1963  -8.327   <2e-16 ***
locationLouisa  -0.1395     0.2809  -0.497     0.62
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

(Dispersion parameter for binomial family taken to be 1)

    Null deviance: 334.87  on 389  degrees of freedom
Residual deviance: 334.63  on 388  degrees of freedom
  (13 observations deleted due to missingness)
AIC: 338.63

Number of Fisher Scoring iterations: 4
No exemplo acima, o coeficiente chamado “locationLouisa” que é de -0.1395 é o log odds ratio de ter diabetes dos pacientes de Louisa comparados com os de Buckingham (que é o valor de referência).
# criando o modelo de regressão logistica
# usando como variável de desfecho a diabetes e como variáveis independentes (preditoras) a idade e gênero
model3 <- glm(diabetes ~ age + gender, data = df, family=binomial (link=logit))

# Mostre o resumo do resultado do modelo de regressão logistica criado acima
summary(model3)
Call:
glm(formula = diabetes ~ age + gender, family = binomial(link = logit),
    data = df)

Coefficients:
             Estimate Std. Error z value Pr(>|z|)
(Intercept) -4.394924   0.552076  -7.961 1.71e-15 ***
age          0.052513   0.009402   5.585 2.34e-08 ***
gendermale  -0.028019   0.298665  -0.094    0.925
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

(Dispersion parameter for binomial family taken to be 1)

    Null deviance: 334.87  on 389  degrees of freedom
Residual deviance: 299.40  on 387  degrees of freedom
  (13 observations deleted due to missingness)
AIC: 305.4

Number of Fisher Scoring iterations: 5Acrescente outras variáveis no modelo de regressão logística
# Acrescente outras variáveis do data frame df ao modelo de regressão logística