Code
# armazenando o dataset num objeto chamado mydata.
mydata <- PlantGrowthO teste Anova (Análise de Variância) foi criado pelo estatístico britânico Ronald Fisher no início do século XX, para comparar as médias de três ou mais grupos independentes, para determinar se há diferenças estatisticamente significativas entre eles.
A ideia central do teste Anova é decompor a variabilidade total dos dados em duas partes: a variabilidade entre os grupos e a variabilidade dentro dos grupos. Se as médias dos grupos forem estatisticamente diferentes, espera-se que a variabilidade entre os grupos seja maior do que a variabilidade dentro dos grupos.
Para exemplificarmos o uso do teste ANOVA vamo usar o dataset PlantGrowth do R. Esse dataset contém o peso das plantas cultivadas sob duas condições de tratamento diferentes e um grupo controle. São, portanto, 3 grupos diferentes de tratamento. Para ter mais informações sobre esse dataset basta digitar ?PlantGrowth no console.
# armazenando o dataset num objeto chamado mydata.
mydata <- PlantGrowth# verificando o dataset
head(mydata) weight group
1 4.17 ctrl
2 5.58 ctrl
3 5.18 ctrl
4 6.11 ctrl
5 4.50 ctrl
6 4.61 ctrl# verificando o dataset
str(mydata)'data.frame': 30 obs. of 2 variables:
$ weight: num 4.17 5.58 5.18 6.11 4.5 4.61 5.17 4.53 5.33 5.14 ...
$ group : Factor w/ 3 levels "ctrl","trt1",..: 1 1 1 1 1 1 1 1 1 1 ...Observe que esse dataset já está no formato long, conforme explicado no capítulo sobre data frames @ref(Dataframes).
Podemos inicialmente computar as estatísticas básicas com a função summarise() do pacote dplyr, conforme explicado no capítulo sobre esse pacote @ref(dplyr).
library(dplyr)
group_by(mydata, group) %>%
  summarise(count = n(),
            mean = mean(weight, na.rm = TRUE),
            sd = sd(weight, na.rm = TRUE))
# A tibble: 3 × 4
group count mean sd
<fct> <int> <dbl> <dbl>
1 ctrl 10 5.03 0.583
2 trt1 10 4.66 0.794
3 trt2 10 5.53 0.443Podemos também visualizar esses conjuntos com um boxplot, conforme explicado no capítulo sobre ggplot @ref(ggplot).
library(ggplot2)
ggplot(mydata, aes(x=group, y=weight, fill=group)) +
  geom_boxplot() +
  ylab("peso") +
  xlab("grupo") +
  theme_classic()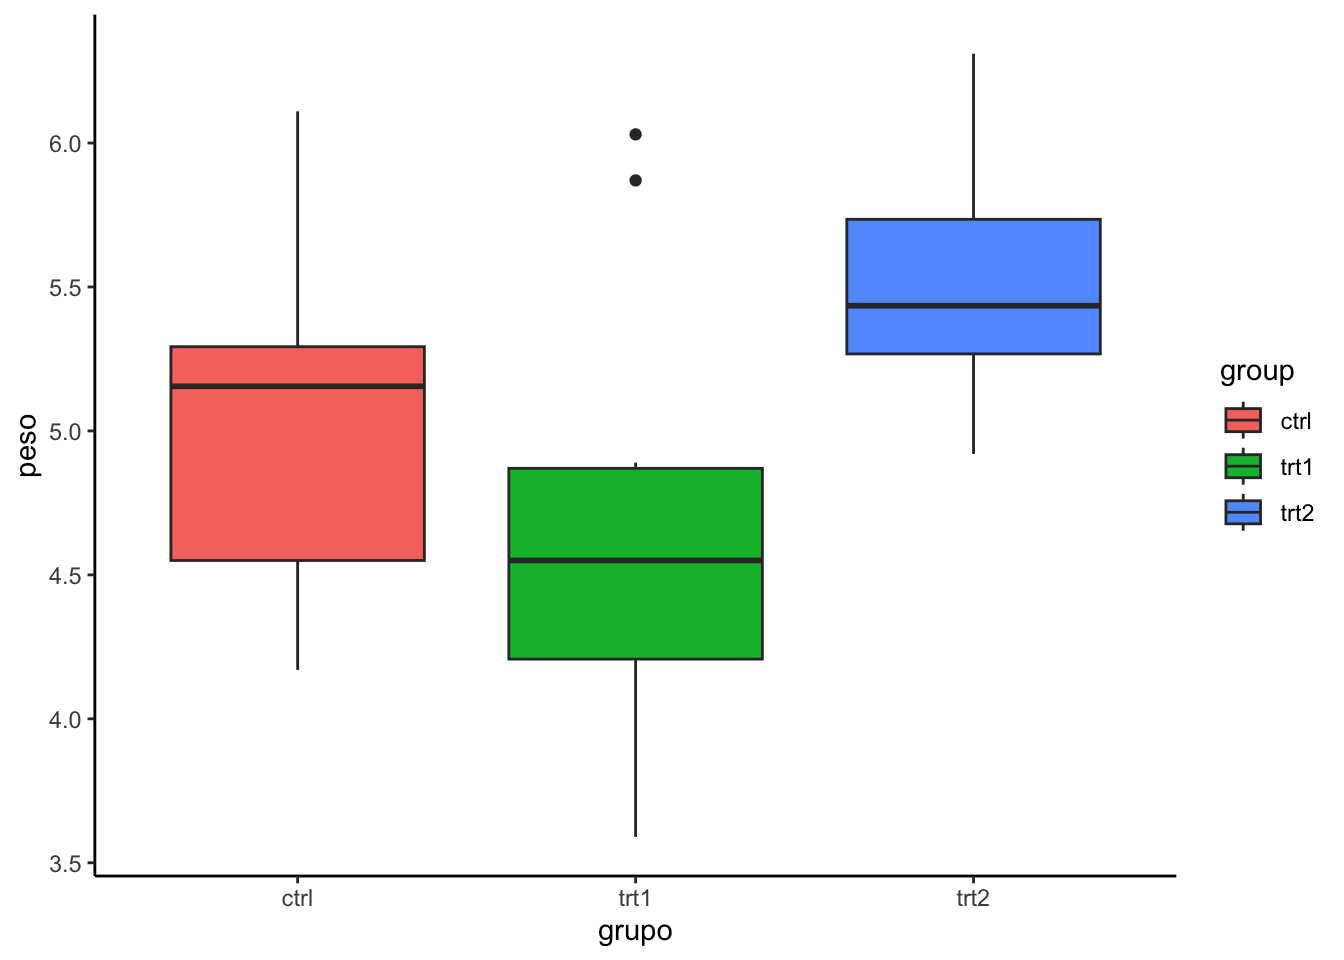
Finalmente, para realizar o teste ANOVA usamos a função aov(). A função summary() será usada em seguida para resumir os dados do modelo de variância. Vamos ver como isso é feito.
Inicialmente precisamos colocar o modelo ANOVA num objeto e indicar nos argumentos da função anova que o peso das plantas será uma função do tratamento. Lembre-se que o peso está na variável weight e o tipo de tratamento na variável group.
modelo_ANOVA <- aov(weight ~ group, data = mydata)Depois de armazenar o modelo ANOVA na variável que denominamos modelo_ANOVA, podemos então usar a função summary(). Essa função tem como argumento justamente o objeto criado anteriormente para armazenar o modelo ANOVA.
summary(modelo_ANOVA) Df Sum Sq Mean Sq F value Pr(>F)
group 2 3.766 1.8832 4.846 0.0159 *
Residuals 27 10.492 0.3886
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1A coluna Pr(>F) indica o valor de p do teste ANOVA. Como o valor foi menor que 0.05 podemos interpretar que algumas das média dos grupo são estatisticamente diferentes, mas não sabemos que pares são estatisticamente diferentes.
Como o teste ANOVA é significativo, podemos calcular Tukey HSD (Tukey Honest Significant Differences, para realizar comparações múltiplas de pares entre as médias dos grupos.
A função TukeyHD() usa o modelo ANOVA que já criamos como argumento.
TukeyHSD(modelo_ANOVA) Tukey multiple comparisons of means
95% family-wise confidence level
Fit: aov(formula = weight ~ group, data = mydata)
$group
diff lwr upr p adj
trt1-ctrl -0.371 -1.0622161 0.3202161 0.3908711
trt2-ctrl 0.494 -0.1972161 1.1852161 0.1979960
trt2-trt1 0.865 0.1737839 1.5562161 0.0120064Explicando o resultado:
diff: mostra a diferença entre as médias dos dois grupos.
lwr: o ponto final inferior do intervalo de confiança em 95% (padrão).
upr: o ponto final superior do intervalo de confiança em 95% (padrão).
p adj: p-valor após ajuste para as comparações múltiplas.
Pode ser visto no resultado acima que apenas a diferença entre trt2 e trt1 é significativa com um valor p ajustado de 0,012.