Code
library(ggplot2) # necessário para usar o dataset mpg
cor(mpg$displ, mpg$cty)
[1] -0.798524Frequentemente precisamos calcular numericamente a força e a direção da correlação entre duas variáveis. A medida estatística mais comum para mensurar a força e a direção da correlação entre duas variáveis numéricas é o Coeficiente de Correlação Linear de Pearson - denotado por r. Vale ressaltar que esse coeficiente só serve para analisar correlações lineares.
A linguagem R tem uma função específica para calcular o coeficiente de correlação linear de Pearson (r) entre duas variáveis numéricas: a função cor(). Para usar essa função basta inserir como argumentos as duas variáveis numéricas para as quais se deseja calcular o coeficiente. A ordem em que as variáveis são inseridas não faz diferença nesse cálculo.
Vamos testar essas funções no dataset mpg que já foi discutido em capítulos anteriores (?@sec-packages). O código abaixo calcula o coeficiente de correlação linear de Pearson entre as cilindradas (displ) e o número de milhas percorridas com um galão na cidade (cty). A ordem da inserção desses argumentos não importa.
library(ggplot2) # necessário para usar o dataset mpg
cor(mpg$displ, mpg$cty)[1] -0.798524cor(mpg$cty,mpg$displ)[1] -0.798524O valor encontrado cor(mpg$cty,mpg$displ) indica que essa é uma correlação negativa e forte. A mensagem é clara, quanto maior as cilindradas, menor a distância percorrida com 1 galão de gasolina, ou seja, carros 1.0 são mais econômicos mesmo.
O valor coeficiente de determinação \(r^2\) pode ser obtido elevando-se a função cor() ao quadrado.
r2 <- cor(mpg$displ, mpg$cty)^2
r2
[1] 0.6376405O intervalo de confiança e o valor de p associado ao coeficiente de correlação podem ser obtidos com a função cor.test().
cor.test(mpg$cty,mpg$displ)
    Pearson's product-moment correlation

data:  mpg$cty and mpg$displ
t = -20.205, df = 232, p-value < 2.2e-16
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 -0.8406782 -0.7467508
sample estimates:
      cor
-0.798524
Frequentemente existem valores NA no conjunto de dados. Nesses casos a função cor() não conseguirá computar o valor do coeficiente de correlação, pois, por padrão, essa função só faz os cálculos se todos os pares de dados estiverem completos. Para calcular a correlação omitindo os pares incompletos é necessário ajustar o parâmetro use =, incluindo use = complete.obs.
Para ilustrar essa situação, usaremos o dataset airquality do R, que contém dados NA em algumas de suas medições. Esse dataset contém dados de medições diárias da qualidade do ar em Nova Iorque de maio a setembro de 1973. São cerca de 154 observações e 6 variáveis numéricas: - Ozone (quantidade de ozônio)
- Solar.R (radiação solar)
- Wind (velocidade do vento)
- Temp (temperatura - F)
- Month (mês) - Day (dia)
Podemos verificar a existência de valores NA com o comando summary()
summary(airquality) Ozone Solar.R Wind Temp
Min. : 1.00 Min. : 7.0 Min. : 1.700 Min. :56.00
1st Qu.: 18.00 1st Qu.:115.8 1st Qu.: 7.400 1st Qu.:72.00
Median : 31.50 Median :205.0 Median : 9.700 Median :79.00
Mean : 42.13 Mean :185.9 Mean : 9.958 Mean :77.88
3rd Qu.: 63.25 3rd Qu.:258.8 3rd Qu.:11.500 3rd Qu.:85.00
Max. :168.00 Max. :334.0 Max. :20.700 Max. :97.00
NA's :37 NA's :7
Month Day
Min. :5.000 Min. : 1.0
1st Qu.:6.000 1st Qu.: 8.0
Median :7.000 Median :16.0
Mean :6.993 Mean :15.8
3rd Qu.:8.000 3rd Qu.:23.0
Max. :9.000 Max. :31.0
Devido as valores NA nas variáveis Ozone e Solar.R, a função cor() não calcula o coeficiente de correlação:
cor(airquality$Ozone, airquality$Solar.R)[1] NAPara obter o resultado desejado, precisamos incluir o argumento use = "complete.obs"
cor(airquality$Ozone, airquality$Solar.R, use = "complete.obs")[1] 0.3483417A inclusão desse argumento faz com que a função cor() exclua dos cálculos os valores NA. O mesmo resultado pode ser obtido se excluirmos esses valores antes de usar a função.
Para demonstrar isso, vamos excluir esses valores com a função drop_na()do pacote tidyr, parte do tidyverse. Criaremos um novo data frame com o nome air2.
library(tidyr)
air2 <- airquality |>
        drop_na()

cor(air2$Ozone, air2$Solar.R)
[1] 0.3483417A função cor.test() já faz essa exclusão dos dados NA por padrão, não sendo necessária sua exclusão nem o uso do argumento use = "complete.obs".
cor.test(airquality$Ozone, airquality$Solar.R)
    Pearson's product-moment correlation

data:  airquality$Ozone and airquality$Solar.R
t = 3.8798, df = 109, p-value = 0.0001793
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 0.173194 0.502132
sample estimates:
      cor
0.3483417 Podemos usar a função pairs() para visualizar rapidamente todas as correlações entre as variáveis de um dataset. Vamos testar essa função no dataset iris do ggplot.
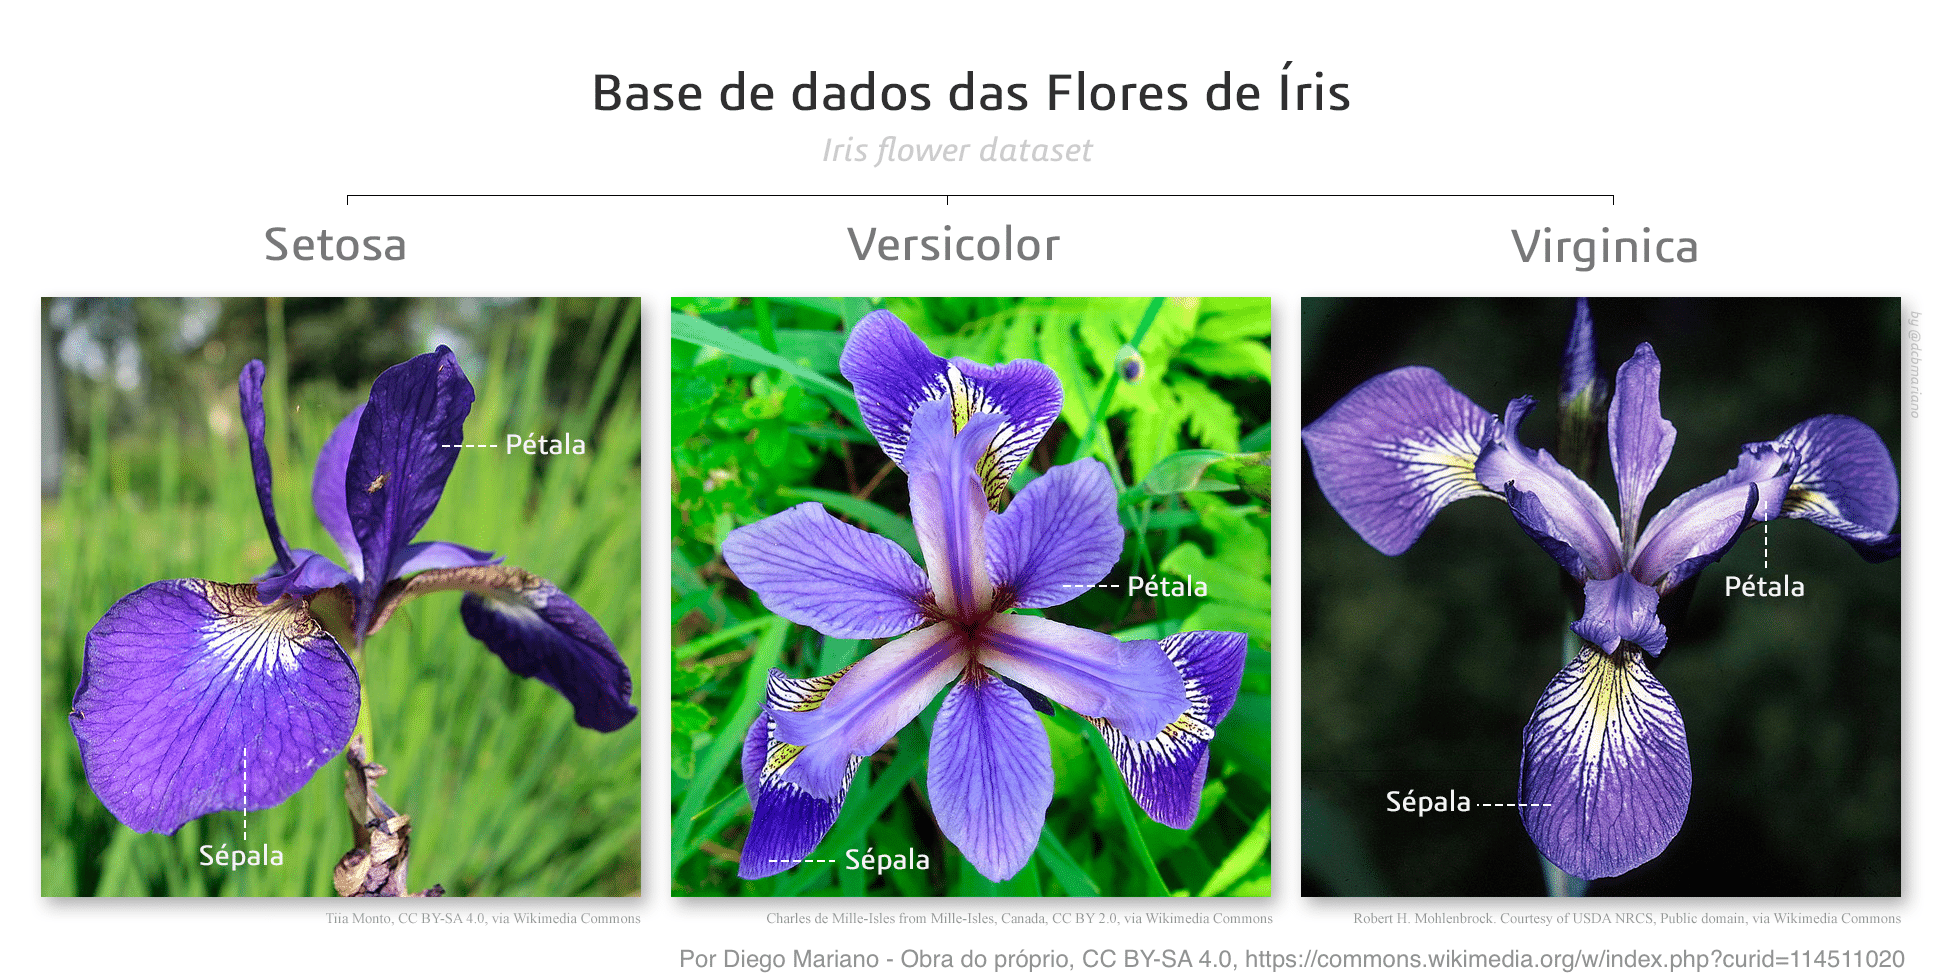
Este conjunto de dados fornece as medidas em centímetros das variáveis comprimento e largura da sépala e comprimento e largura da pétala, respectivamente, para 50 flores de cada uma das 3 espécies de íris. As espécies são Iris setosa, versicolor e virginica.
pairs(iris)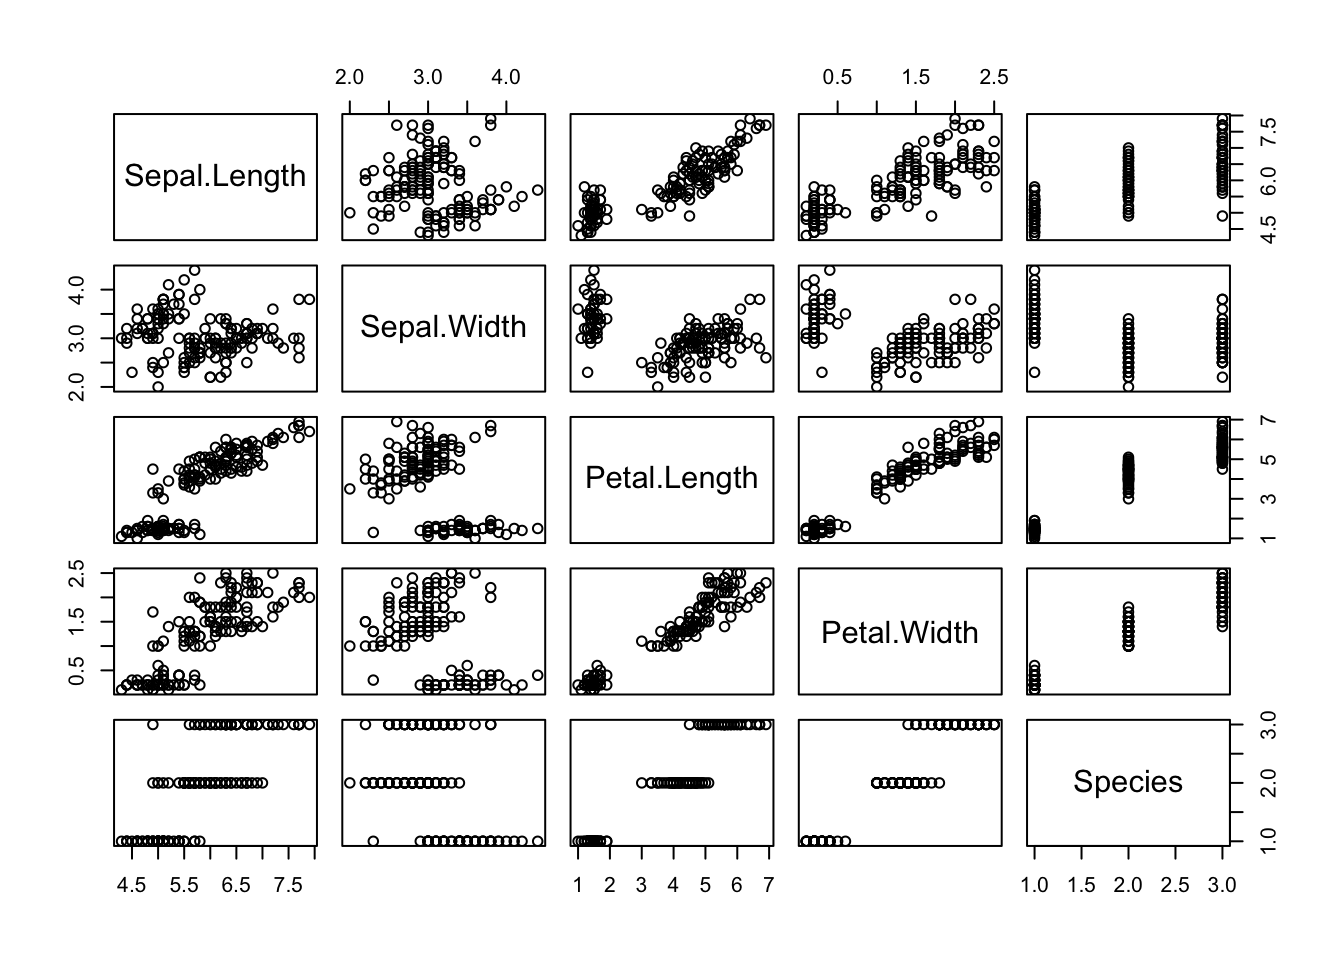
O pacote GGally possui uma função similar à função pairs() do R, mas com muito mais funcionalidades. Para usá-la, é necessário instalar o pacote GGally através do comando install.packages("GGally") no console.
library(GGally)ggpairs(iris)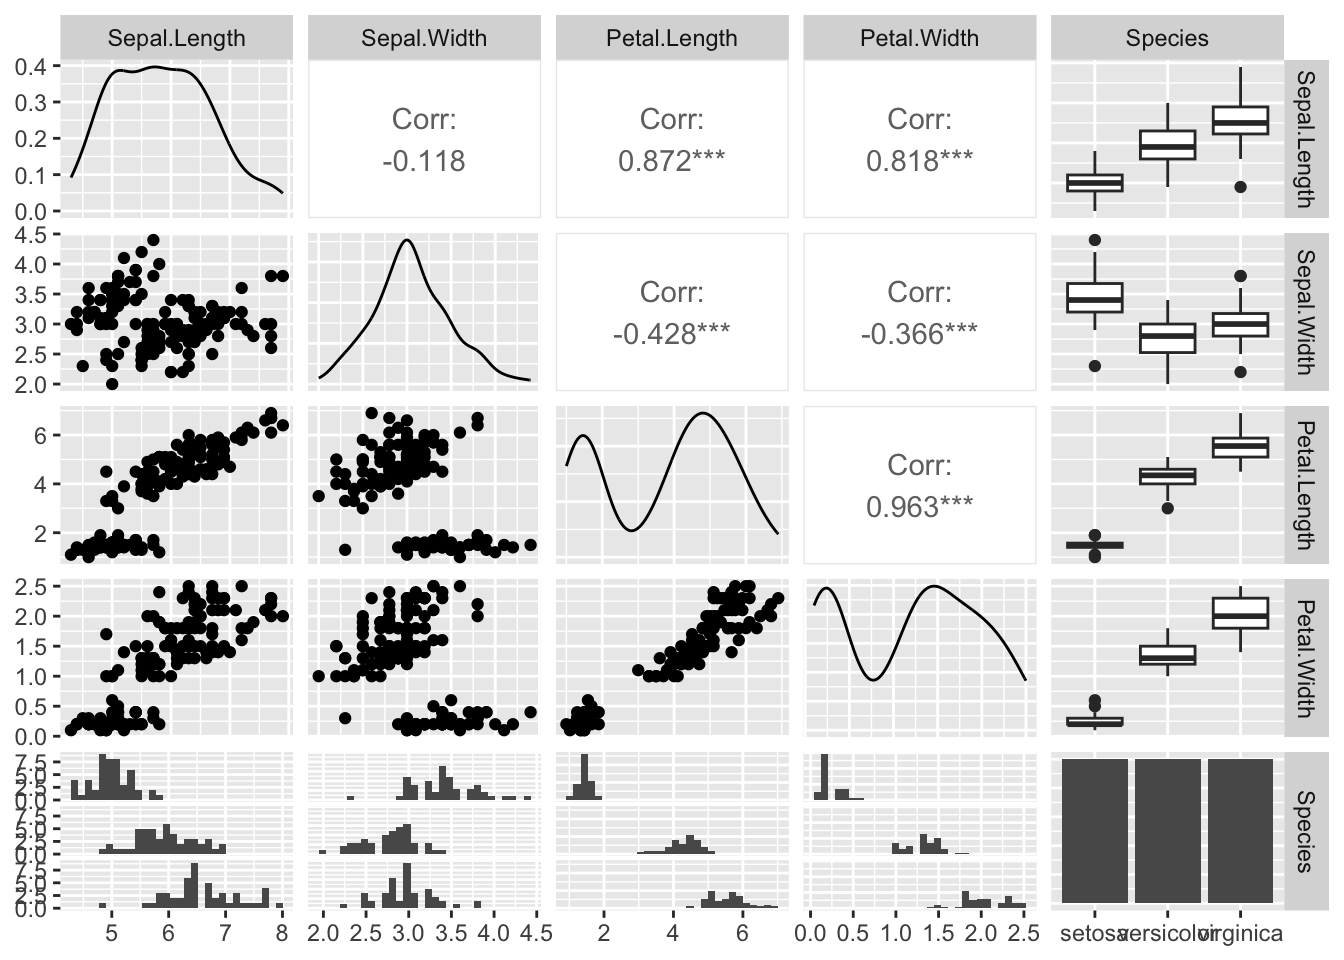
Podemos também pedir à função ggpairs() que use cores diferentes para cada espécie.
ggpairs(iris, mapping = aes(color = Species))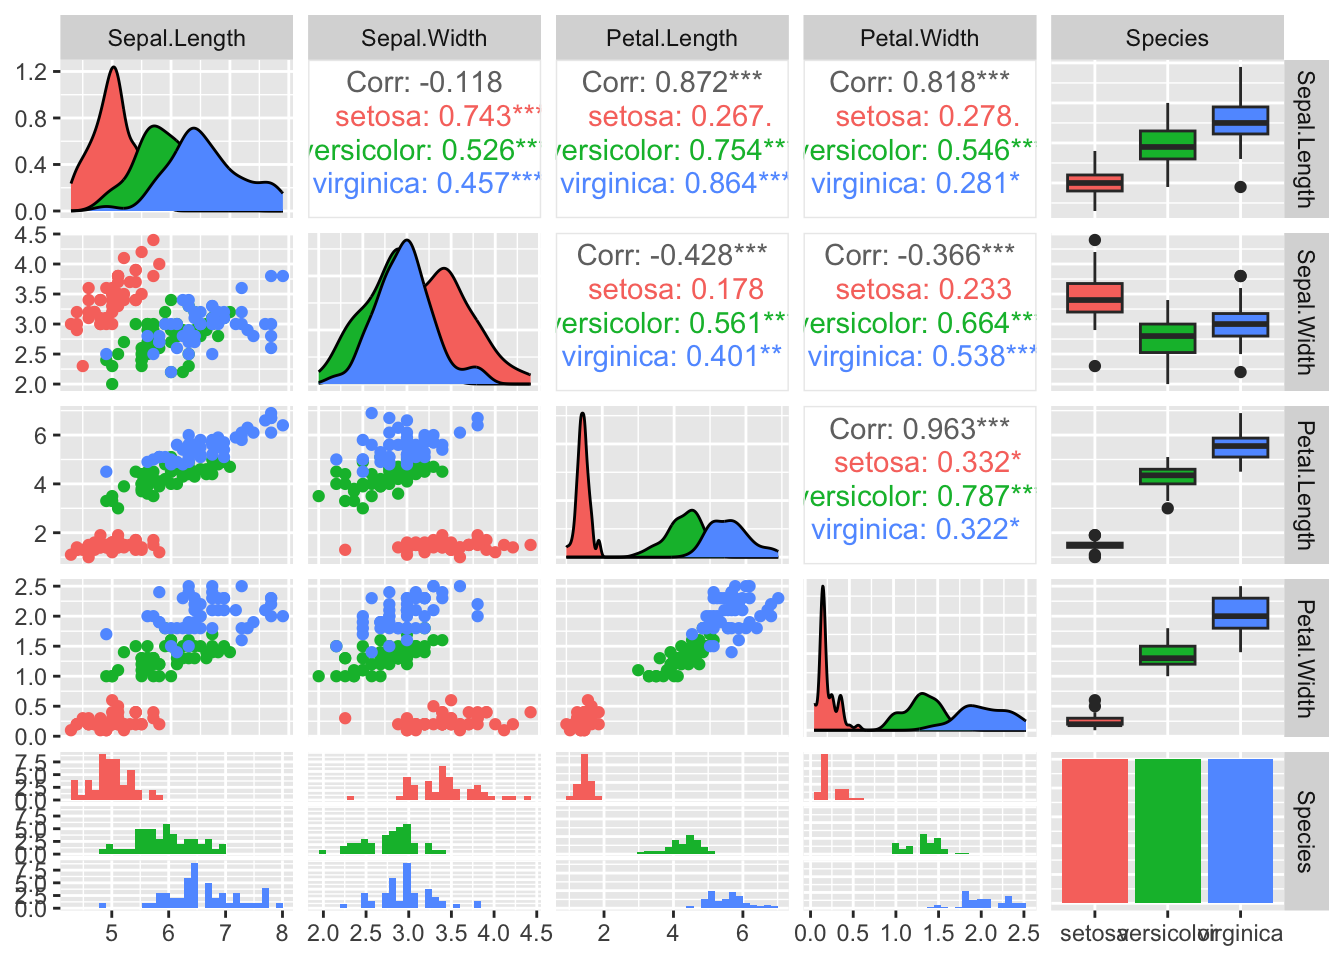
Podemos obter o mesmo resultado usando o operador pipe:
iris |>
  ggpairs(aes(color = Species))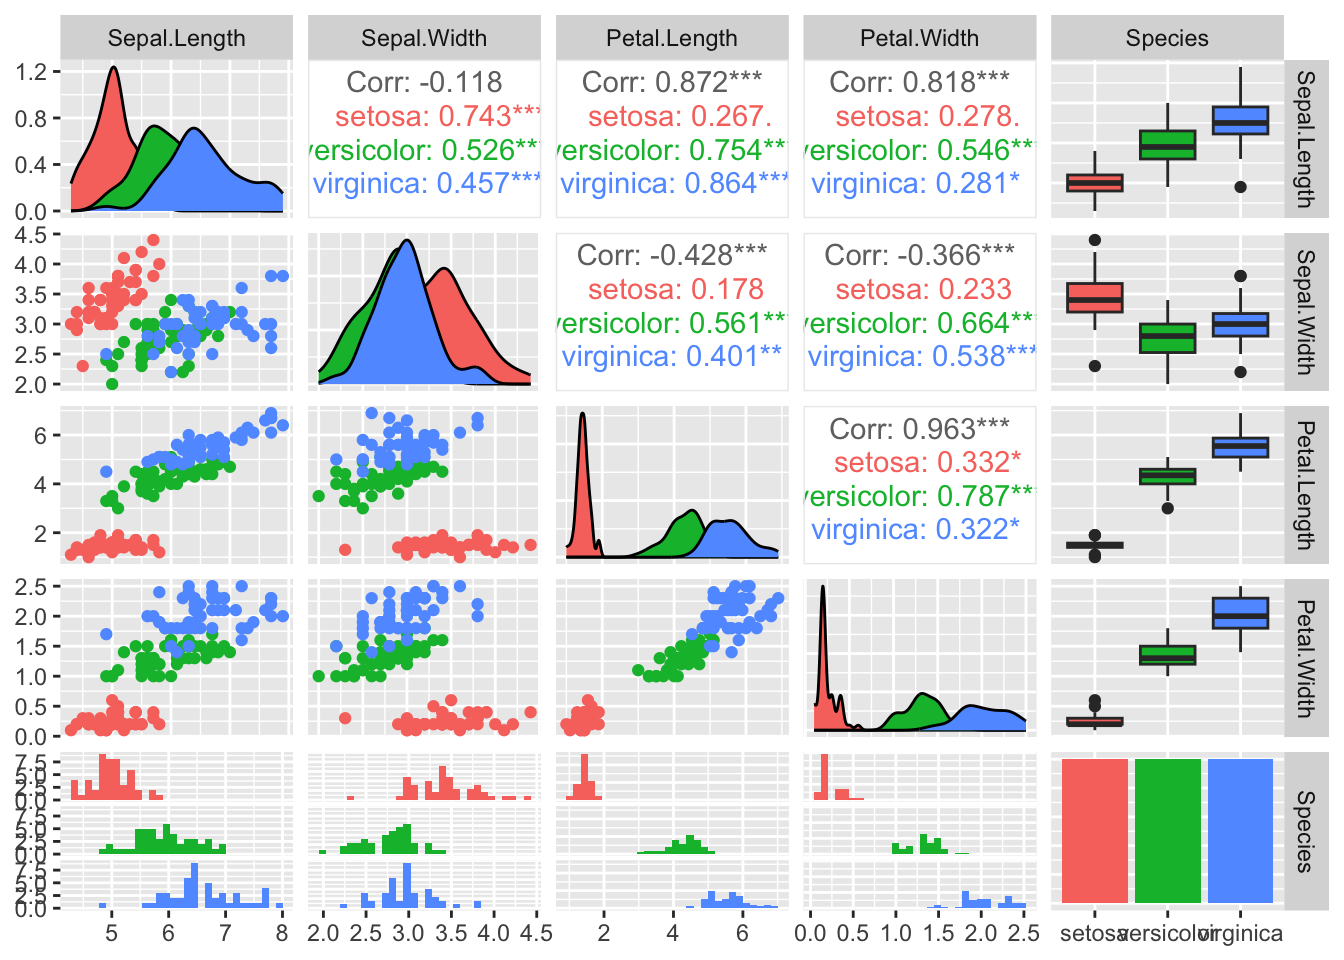
A forma mais simples de visualizar a correlação entre duas variáveis é através de um gráfico de scatter plot. Essa relação pode ser mostrada de forma ainda mais explícita quando inserimos no gráfico uma reta que representa a correlação linear entre essas variáveis. Essa reta, chamada de reta de regressão linear, representa o modelo matemático de correlação entre essas duas variáveis.
A função básica do R para criar um scatterplot e simplesmente plot() e a inserção da linha de regressão é feita com a função abline() e lm(), de linear model. Vejamos como plotar um gráfico de correlação entre os níveis de ozônio e a radiação solar com esses comandos, usando o dataset airquality do R.
plot(Solar.R ~ Ozone, data = airquality)
abline(lm(Solar.R ~ Ozone, data = airquality))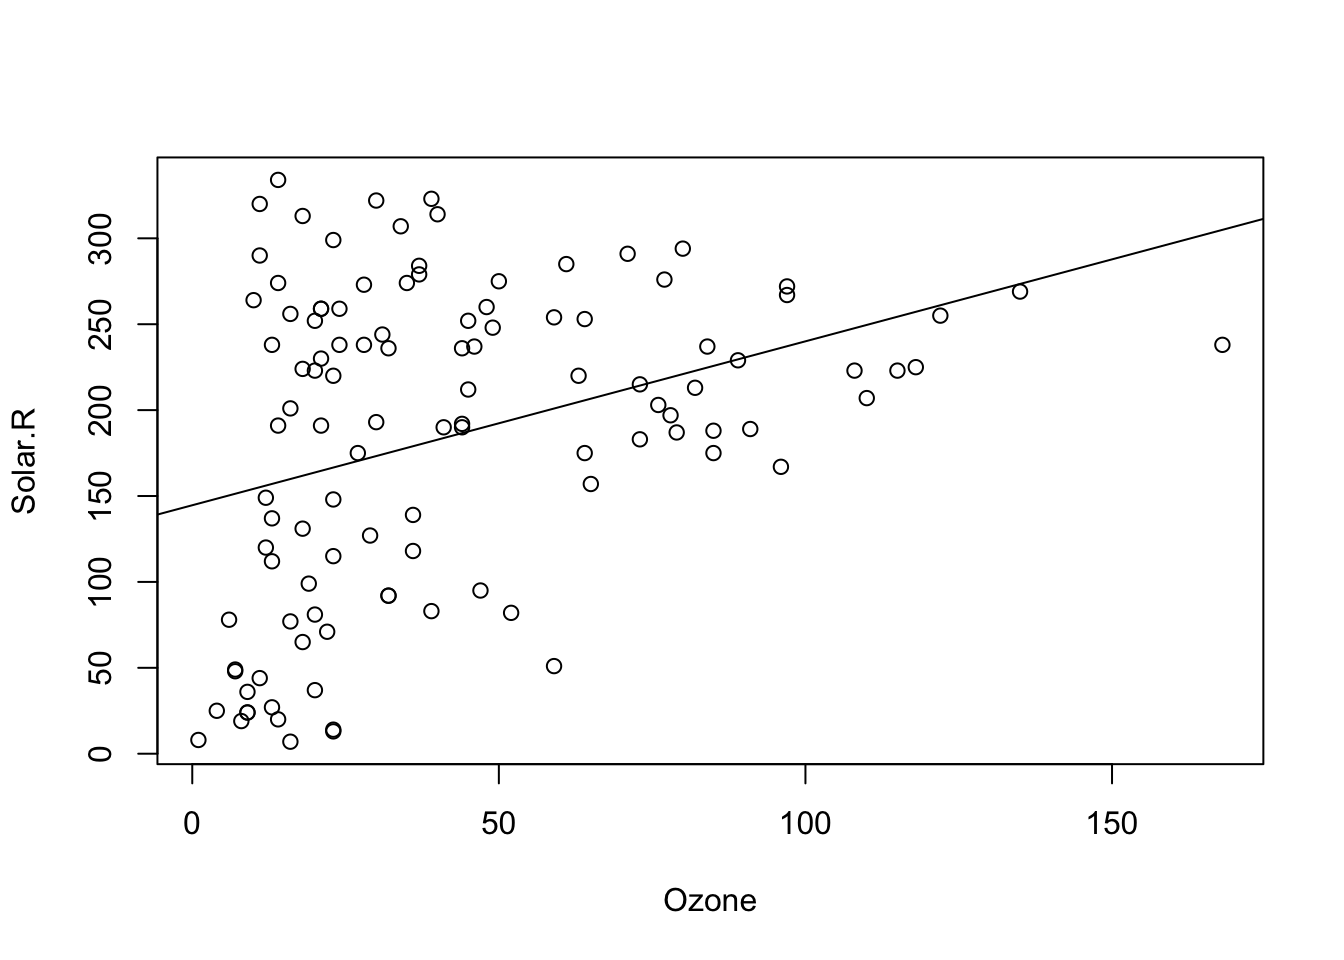
Apesar dos comandos do R base serem simples, não são nada elegantes. Os gráficos com o ggplot são muito mais profissionais e bem mais flexíveis para ajustes dos detalhes. Vamos plotar esse mesmo gráfico com o ggplot, usando o geom_point() para plotar o scatter plot.
ggplot(airquality)  +
  geom_point(aes(x=Ozone, y=Solar.R))
Warning: Removed 42 rows containing missing values or values outside the scale range
(`geom_point()`).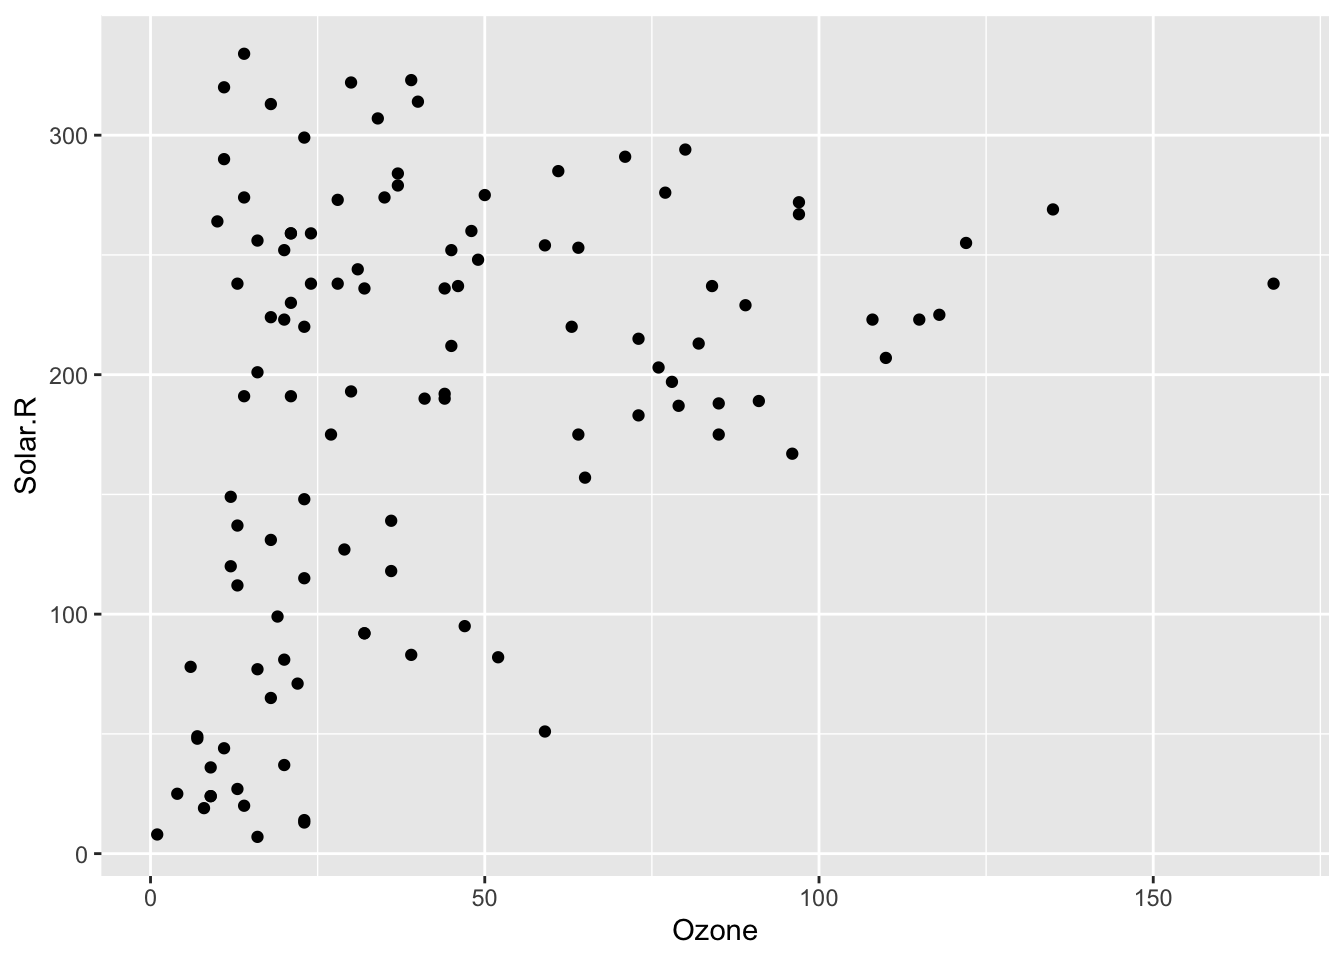
Para plotar a reta de regressão basta incluir uma nova camada, uma nova geometria, nesse caso geom_smooth(), indicando como argumentos os mesmos dados e o método linear model lm.
ggplot(airquality)  +
  geom_point(aes(x=Ozone, y=Solar.R)) +
  geom_smooth(aes(x=Ozone, y=Solar.R), method = lm)
`geom_smooth()` using formula = 'y ~ x'Warning: Removed 42 rows containing non-finite outside the scale range
(`stat_smooth()`).Warning: Removed 42 rows containing missing values or values outside the scale range
(`geom_point()`).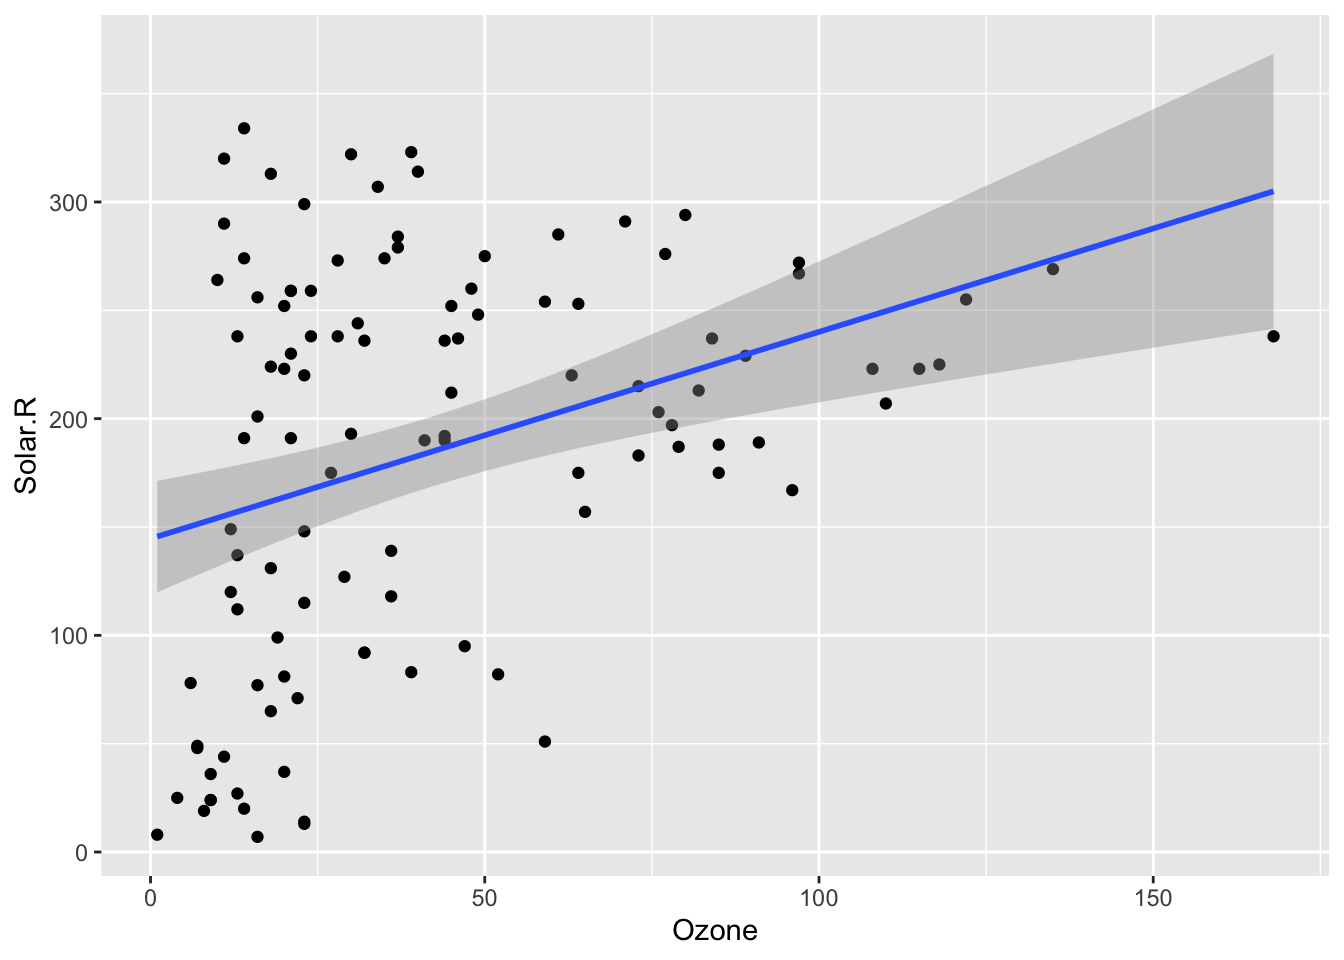
Observe entretanto que o código acima repete duas vezes a expressão aes(x=Solar.R, y=Ozone). Podemos reduzir esse código, inserindo essa expressão na primeira linha, o que deixa o código mais limpo, como feito abaixo:
ggplot(airquality, aes(x=Ozone, y=Solar.R))  +
  geom_point() +
  geom_smooth(method = lm)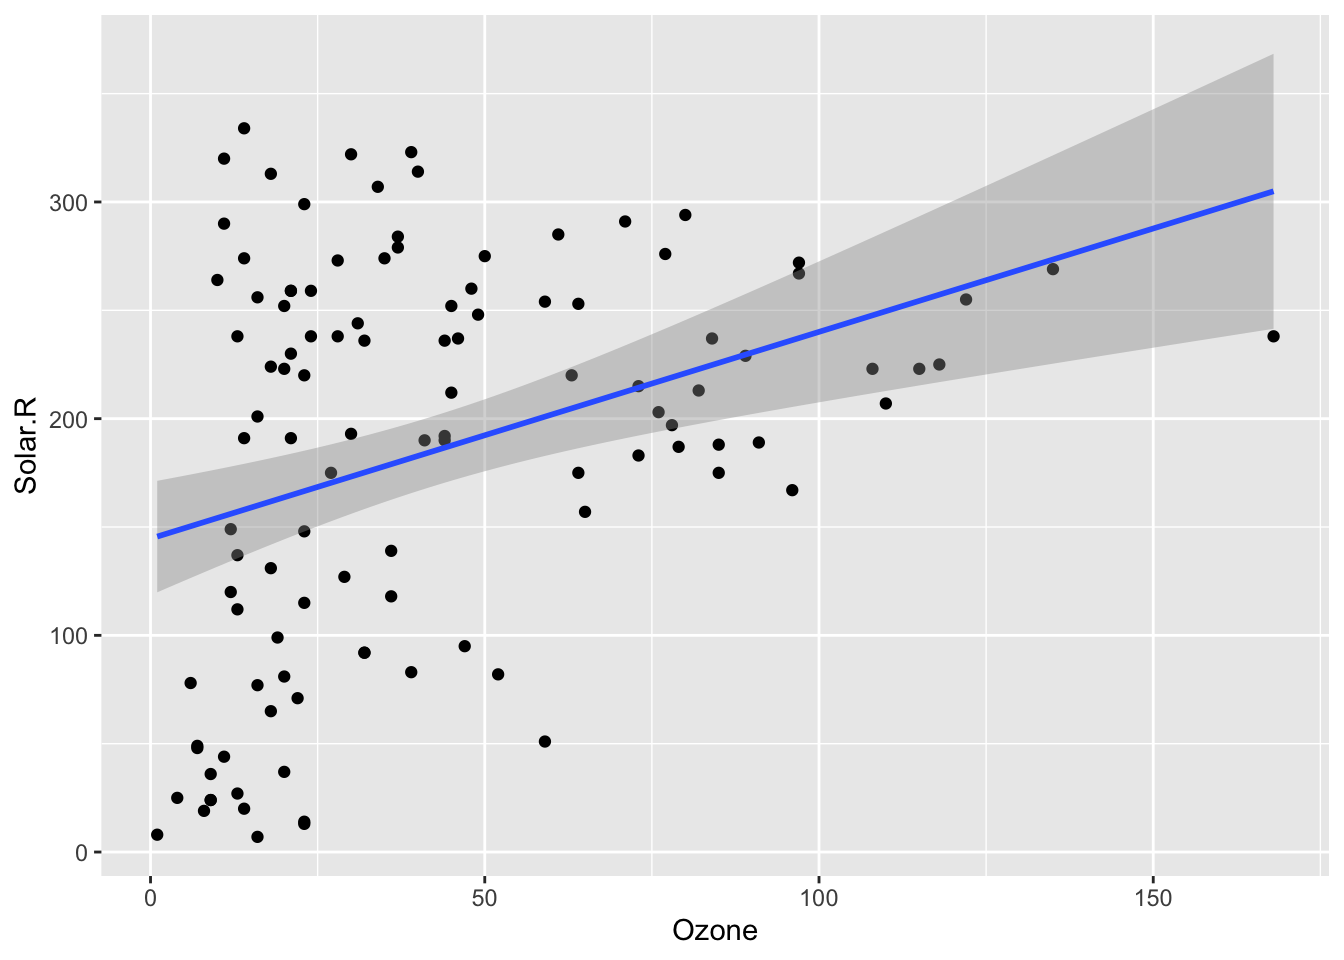
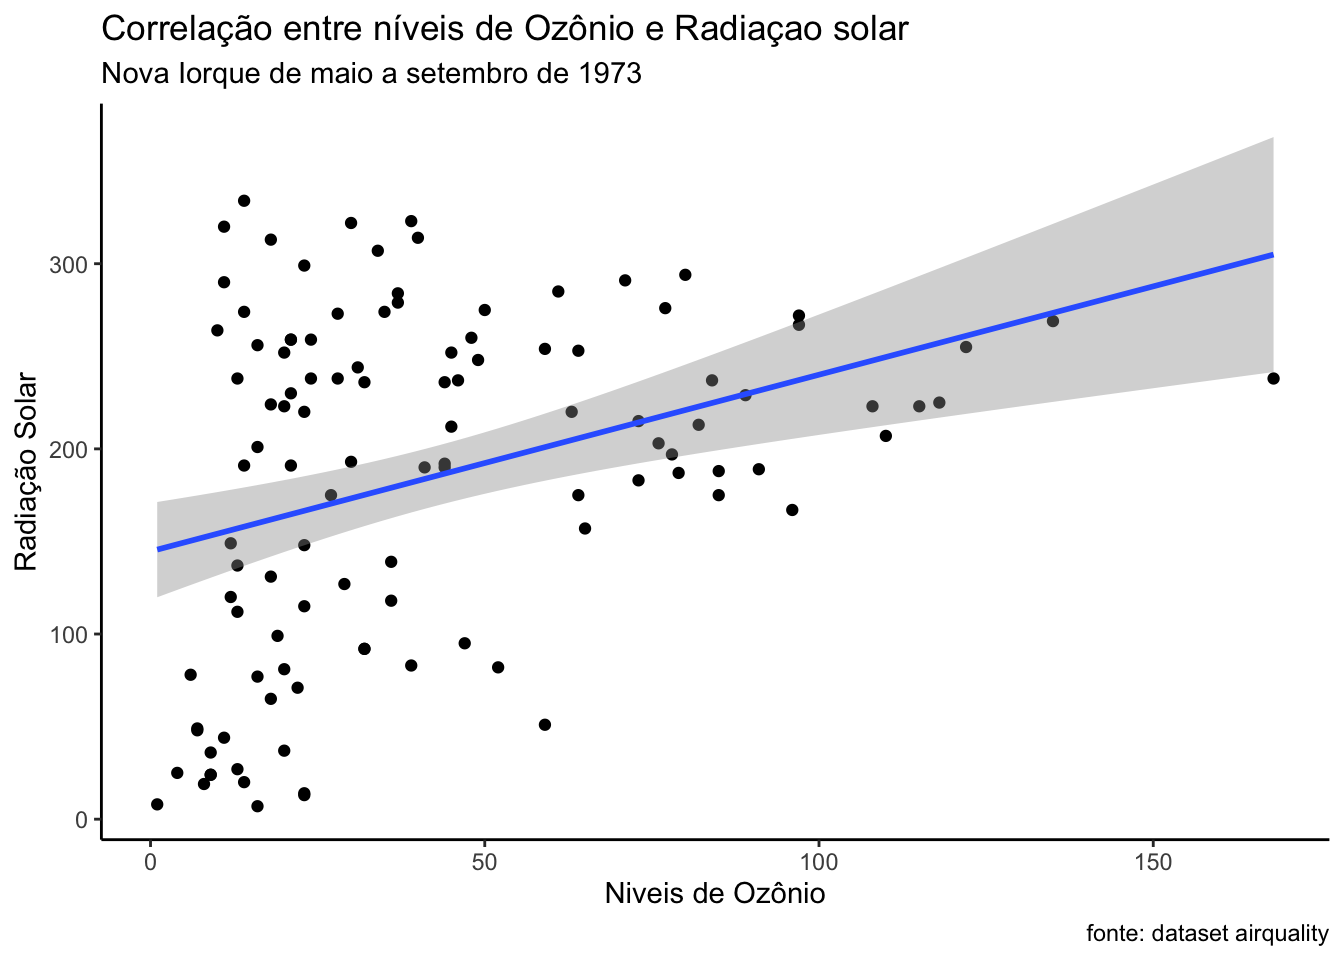
O ggplot tem também inúmeras outras possibilidades de ajustes. No código a seguir irei inserir um título, subtítulo, nota de rodapé, mudar os nomes dos eixos e usar um tema pré-definido para estilização do gráfico.
ggplot(airquality, aes(x=Ozone, y=Solar.R))  +
  geom_point() +
  geom_smooth(method = lm) +
  labs(title = "Correlação entre níveis de Ozônio e Radiaçao solar",
       subtitle = "Nova Iorque de maio a setembro de 1973",
       caption = "fonte: dataset airquality") +
  ylab("Radiação Solar") +
  xlab("Niveis de Ozônio") +
  theme_classic()