O test t de Student foi criado em 1908 por William Sealy Gosset (Student 1908), matemático e estatístico que trabalhava na cervejaria Guinness, em Dublin, na Irlanda. A Guinness considerava de grande importância recrutar os melhores graduados de Oxford e Cambridge para os cargos de bioquímico e estatístico de testes de sua cerveja para monitorar a qualidade da bebida. O teste t, desenvolvido por Gosset, para monitorar a qualidade da cerveja tipo stout tinha como grande diferencial o fato de poder ser aplicado em amostras de pequeno tamanho pequeno, permitindo fazer inferências com um menor número de elementos, reduzindo os custos da pesquisa.
A importância dada ao departamento científico da Guinness era tamanha que o uso de métodos estatísticos na fabricação da cerveja era considerado um segredo industrial. Alguns autores argumentam que foi esse o motivo pelo qual Gosset publicou o artigo sobre o teste t em 1908 sob o pseudônimo “Student” e o teste t passou a ser conhecido como teste t de Student.
O teste t de Student (ou simplesmente teste t) compara as médias de dois conjuntos numéricos e avalia se as diferenças entre essas médias são significativas. Quando existem mais de 3 grupos o test t não pode ser usado e nesse caso podemos usar o Anova, discutido no capítulo seguinte.
A necessidade de determinar se duas médias de amostras são diferentes entre si é uma situação extremamente frequente em pesquisas científicas. Por exemplo se um grupo experimental difere de um grupo controle, se uma amostra difere da população, se um grupo difere antes de depois de um procedimento. Nessas diversas situações, um método bastante comum é a comparação das médias da medida de interesse. Por exemplo, a média de peso de dois grupos submetidos a diferentes dietas.
Os 3 tipos de teste t de Student
Existem 3 tipos comuns de teste t:
- Teste t para duas amostras independentes (ou não pareadas), para comparar as médias de duas amostras independentes.
- Teste t para duas amostras dependentes (ou pareadas), para comparar as médias de duas amostras pareadas.
- Teste t para uma amostra, para comparar a média de uma amostra com a média de uma população.
Teste t para amostras independentes
O Teste t para amostras independentes é o teste padrão, ou default do test t do R.
O R tem uma função muito simples de usar para realizar o teste t: t.test(). Para usar essa função basta incluir como argumentos os valores obtidos de cada grupo da pesquisa e essa função do R já calcula a média de cada grupo e faz a comparação estatística.
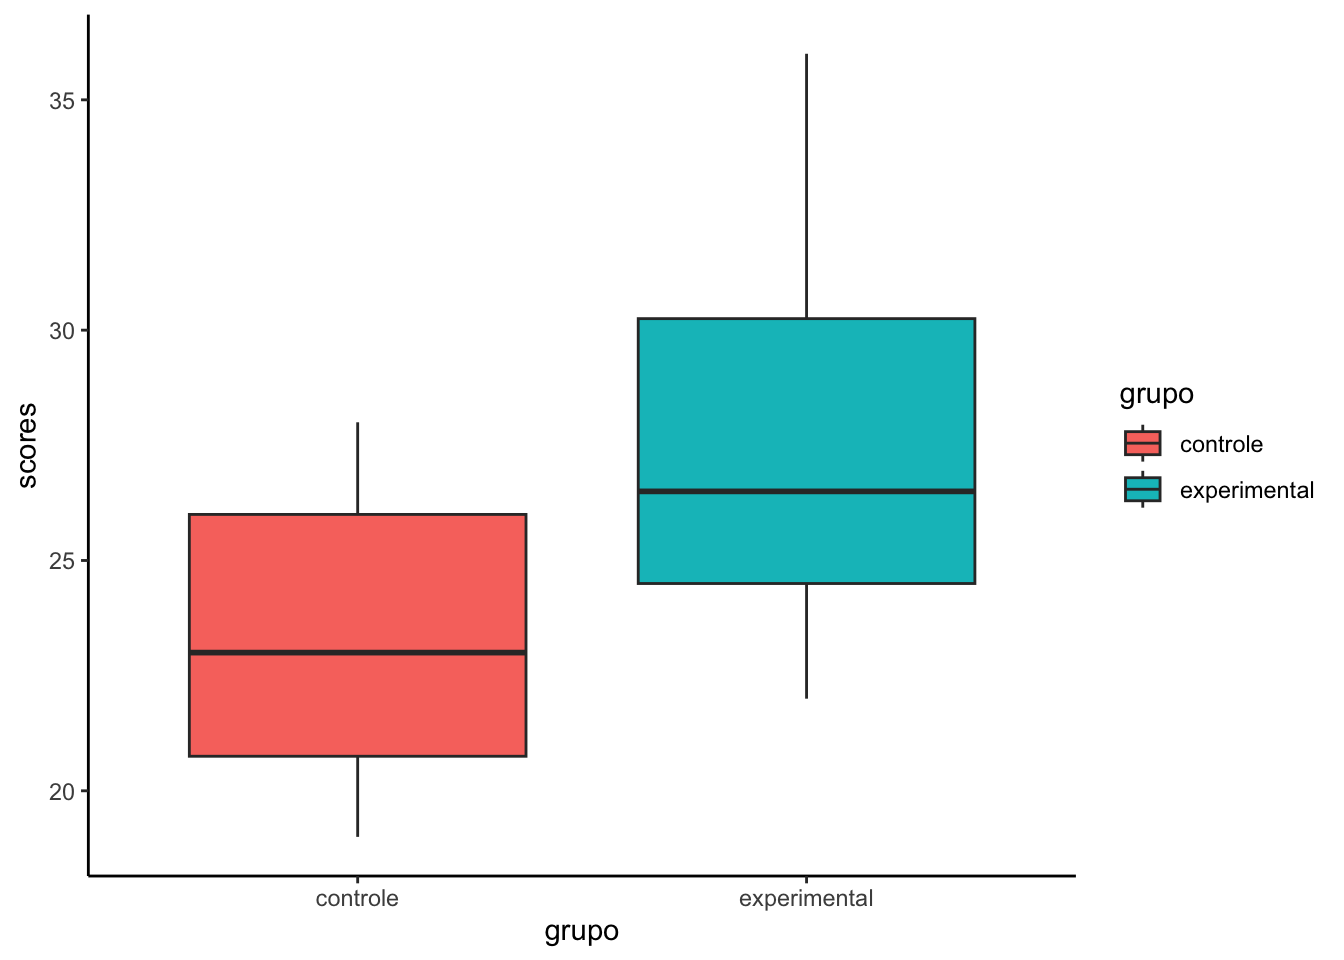
Veja o exemplo a seguir, no qual existem dois grupos diferentes de pacientes (controle e experimental), com os valores de uma medida fictícia. Vamos primeiro criar dois conjuntos de dados numéricos, representando os valores individuais de alguma medida de um Ensaio Clínico Randomizado.
Code
# criando os vetores com os dados:controle <-c(21, 28, 24, 23, 23, 19, 28, 20, 22, 20, 26, 26)experimental <-c(26, 27, 23, 25, 25, 29, 30, 31, 36, 23, 32, 22)# criando uma tibble para armazenar os vetores.result <-tibble(controle, experimental)result
Muitas vezes antes de algumas análises, teremos de fazer uma transformação em nosso data frame (ou tibble), transformando o data frame do tipo wide em long como explicado no capítulo do pacote tidyr no livro texto do curso Manual Básido da Linguagem R.
Code
# carregando o pacote tidyrlibrary(tidyr)# criando um data frame do tipo longresult.long <-pivot_longer(data = result,cols =c("controle", "experimental"),names_to ="grupo", values_to ="scores")result.long
Para comparar a média de cada um desses dois grupos, usamos a função t.test() como mostrado a seguir. Podemos fazer o test t de várias formas.
Podemos usar os vetores numéricos comom argumentos.
Podemos usar o data frame wide (ou tibble), selecionando as colunas como argumentos usando o operador $.
podemos usar o data frame (ou tibble) no formato long.
1. Teste t com vetores numéricos
Code
# Teste t de Student para amostras independentes, padrão do R# usando os vetores com os dados como argumentos.t.test(controle, experimental)
    Welch Two Sample t-test

data:  controle and experimental
t = -2.6837, df = 20.163, p-value = 0.01421
alternative hypothesis: true difference in means is not equal to 0
95 percent confidence interval:
 -7.2555305 -0.9111362
sample estimates:
mean of x mean of y
 23.33333  27.41667
2. Teste t com data frame wide
Se o data frame com os dados está no formaro wide (tidy format), ou seja, se há uma coluna para cada amostra, para realizar o test t, basta usar o operador $ para acessar as variáveis do data frame a serem comparadas.
Code
t.test(result$controle, result$experimental)
    Welch Two Sample t-test

data:  result$controle and result$experimental
t = -2.6837, df = 20.163, p-value = 0.01421
alternative hypothesis: true difference in means is not equal to 0
95 percent confidence interval:
 -7.2555305 -0.9111362
sample estimates:
mean of x mean of y
 23.33333  27.41667
Podemos também informar o dataset primeiro e depois incluir os nomes das colunas/variáveis.
Code
t.test(data=result, controle,experimental)
    Welch Two Sample t-test

data:  controle and experimental
t = -2.6837, df = 20.163, p-value = 0.01421
alternative hypothesis: true difference in means is not equal to 0
95 percent confidence interval:
 -7.2555305 -0.9111362
sample estimates:
mean of x mean of y
 23.33333  27.41667
3. Teste t com data frame long
Se os dados das duas amostras estão numa mesma coluna (long format), e se há uma outra coluna para identificar os grupos, o argumento para o teste t é um pouco diferente. Nesse caso, precisamos usar o operador ~ para informar ao teste que desejamos usar os dados de uma coluna (ex: scores), estratificados em dois grupos segundo os dados de uma outra coluna (ex. grupos)
Code
# teste t com data frame do tipo long# explicação: os dados numéricos estão na coluna "score", a informação sobre os grupos está na variável "grupos".t.test(scores~grupo, data=result.long)
    Welch Two Sample t-test

data:  scores by grupo
t = -2.6837, df = 20.163, p-value = 0.01421
alternative hypothesis: true difference in means between group controle and group experimental is not equal to 0
95 percent confidence interval:
 -7.2555305 -0.9111362
sample estimates:
    mean in group controle mean in group experimental
                  23.33333                   27.41667
Teste t para amostras dependentes ou pareadas
Se as amostras são dependentes, ou pareadas, precisamos incluir essa informação nos argumentos no teste. Vamos usar o mesmo data frame criado anteriormente, supondo que as medidas numéricas fossem de uma mesma amostra em dois momentos do tempo. Nesse caso o teste t deve ser um test pareado. Basta inserir o argumento paired = TRUE.
Code
t.test(controle, experimental, paired =TRUE)
    Paired t-test

data:  controle and experimental
t = -2.6353, df = 11, p-value = 0.02319
alternative hypothesis: true mean difference is not equal to 0
95 percent confidence interval:
 -7.493713 -0.672954
sample estimates:
mean difference
      -4.083333
    Paired t-test

data:  result$controle and result$experimental
t = -2.6353, df = 11, p-value = 0.02319
alternative hypothesis: true mean difference is not equal to 0
95 percent confidence interval:
 -7.493713 -0.672954
sample estimates:
mean difference
      -4.083333
Entretanto, quando usamos a sintaxe do teste com o operador ~ não podemos inserir o argumento paired = TRUE, senão teremos um erro. Esse Parece ser um bug de algumas versões do R, que talvez seja corrigido no futuro.
Teste t para uma amostra.
No caso de uma amostras, para comparar a média de uma amostra com uma média já conhecida, basta inserir nos argumentos do teste t a amostras e o valor da média a ser comparada, como mostrado abaixo.
Para esse exemplo, vamos usar o dataset wide, chamado result, criado acima, e usar o conjunto de dados chamdo experimental como se fosse nossa única amostra. E vamos inserir um valor arbitrário da média a ser comparada (mu = 30).
Code
t.test(result$experimental, mu=30)
    One Sample t-test

data:  result$experimental
t = -2.1044, df = 11, p-value = 0.05915
alternative hypothesis: true mean is not equal to 30
95 percent confidence interval:
 24.71479 30.11854
sample estimates:
mean of x
 27.41667
Podemos também informar o dataset primeiro e depois incluir o nome da coluna/variável.
Code
t.test(data = result, experimental, mu=30)
    One Sample t-test

data:  experimental
t = -2.1044, df = 11, p-value = 0.05915
alternative hypothesis: true mean is not equal to 30
95 percent confidence interval:
 24.71479 30.11854
sample estimates:
mean of x
 27.41667
Extraindo os resultados do teste t
O output dos testes estatísticos no R é uma lista com diversos resultados, que podem ser acessados com o operador $, tal como elementos de um data frame. Podemos verificar a estrutura dessa lista com o comando str(). Mas para isso é preciso armazenar o resultado do test num objeto. Chamaremos aqui esse objeto de test.results.
Code
# armazemando os resultados do test num objeto chamado test.resultstest.results <-t.test(scores~grupo, data=result.long)
Code
# verificando o objeto test.results com strstr(test.results)
List of 10
 $ statistic  : Named num -2.68
  ..- attr(*, "names")= chr "t"
 $ parameter  : Named num 20.2
  ..- attr(*, "names")= chr "df"
 $ p.value    : num 0.0142
 $ conf.int   : num [1:2] -7.256 -0.911
  ..- attr(*, "conf.level")= num 0.95
 $ estimate   : Named num [1:2] 23.3 27.4
  ..- attr(*, "names")= chr [1:2] "mean in group controle" "mean in group experimental"
 $ null.value : Named num 0
  ..- attr(*, "names")= chr "difference in means between group controle and group experimental"
 $ stderr     : num 1.52
 $ alternative: chr "two.sided"
 $ method     : chr "Welch Two Sample t-test"
 $ data.name  : chr "scores by grupo"
 - attr(*, "class")= chr "htest"
podemos extrair o valor de p, ou qualquer outro valor usando o operador $.
Code
p_value <- test.results$p.valuep_value
[1] 0.01421353
Veja que cada informação do teste está armazenada numa variável que podemos agora acessar. Isso é útil para escrevermos relatórios dinâmicos. Veja a seguinte frase abaixo:
A diferença entre as médias foi estatisticamente significativa (p=0.0142135).
Nessa frase eu não digitei o valor de p, mas inseri a variável p_value. Isso é o que torna os relatórios dinâmicos, pois se houver alguma mudança nos dados, basta rodar novamente o código e o valor de p no texto vai ser automaticamente corrigido.
Essa foi a frase que eu digitei:
A diferença entre as médias foi estatisticamente significativa (p= `r p_value`).
O backtick (backquote ou acento grave) informa o início e o fim de um código, a letra r logo no início informa que o código a seguir é um código da linguagem R e p_value vai ser então interpretado como a variável p_value e seu valor é que será mostrado no texto.
Atente-se para o detalhe de que as médias estão numa mesma variável estimate:
Code
test.results$estimate
    mean in group controle mean in group experimental
                  23.33333                   27.41667
Para acessar cada um desses valores individualmente é necessário indicar isso explicitamente usando o operador [].
Code
test.results$estimate[1]
mean in group controle
              23.33333
Veja que da forma como fizemos acima o resultado foi a média do grupo controle, mas o texto veio junto. Para extrair apenas o valor numérico devemos incluir mais um elemento no código, a função as.mumeric().
Code
as.numeric(test.results$estimate[1])
[1] 23.33333
References
Student. 1908. “The Probable Error of a Mean.”Biometrika, 1–25.