Code
# Definindo a semente para reprodutibilidade
set.seed(1)

# Gerando os dados distribuidos de forma normal
dados <- rnorm(100)

# Gráfico Q-Q plot
qqnorm(dados) # Gráfico Q-Q plot
qqline(dados) # Adiciona a linha de referência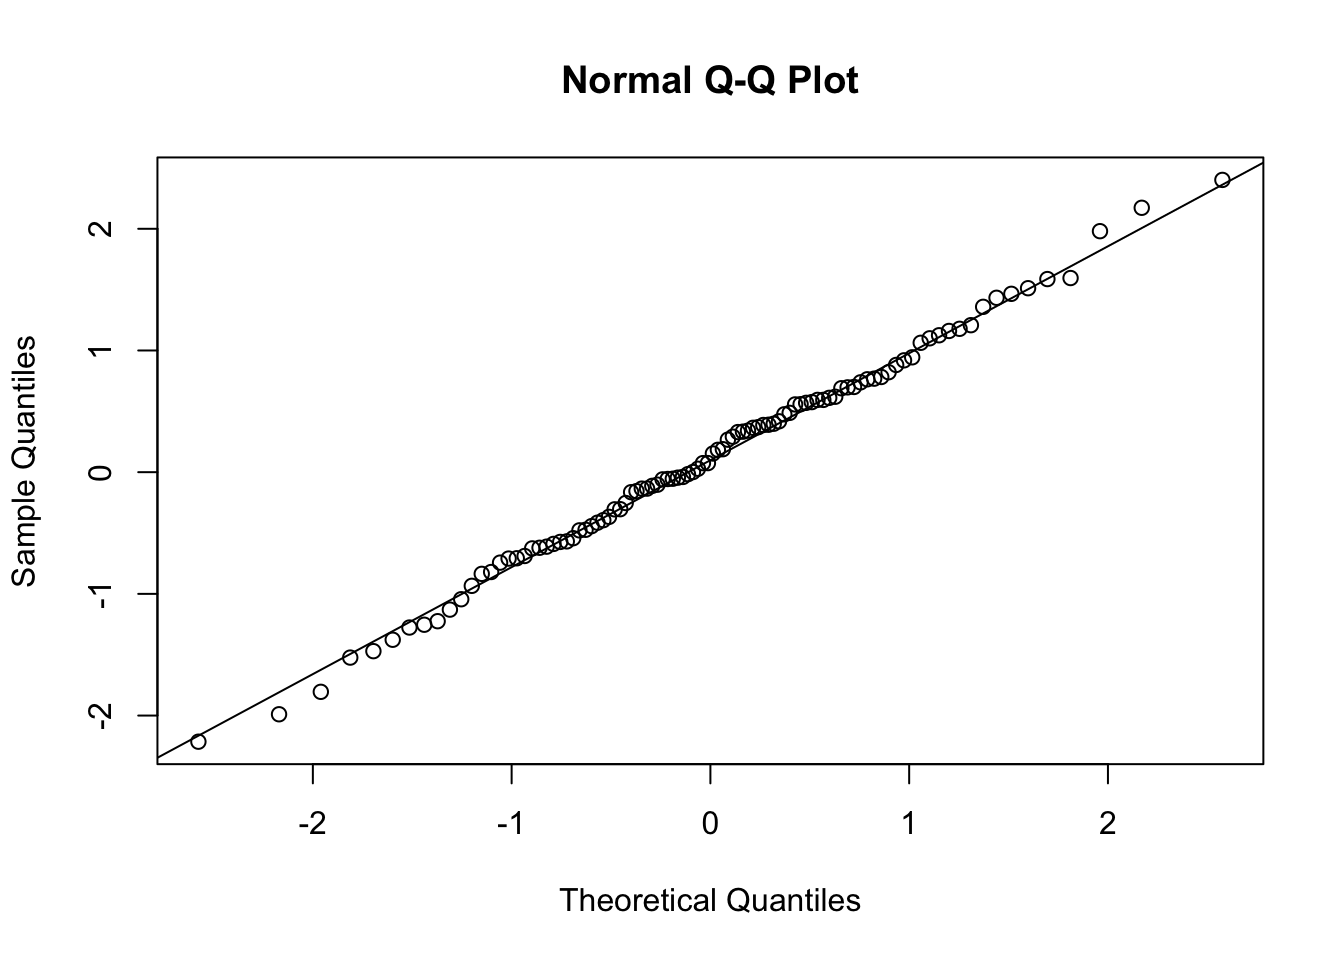
A normalidade dos dados é uma das premissas dos testes estatísticos paramétricos. A normalidade dos dados pode ser avaliada visualmente através de gráficos de densidade e de histograma, através de gráficos como o QQ plot (quantile–quantile plot), ou através de testes estatísticos. Neste capítulo vamos apresentar como fazer os gráficos Q-Q plot e como implementar no R os testes de normalidade de Shapiro-Wilk e Kolmogorov-Smirnov.
Um QQ plot, abreviação de “quantile-quantile plot”, é geralmente usado para avaliar se um conjunto de dados segue ou não uma distribuição normal. Um QQ plot é um gráfico de dispersão (scatter plot) criado plotando dois conjuntos de quantis um contra o outro. Os gráficos QQ classificam os dados da amostra em ordem crescente e, em seguida, plotam esses pontos contra quantis calculados a partir de uma distribuição teórica. Embora os gráficos QQ normais sejam os mais usados na prática devido a tantos métodos estatísticos que assumem normalidade, os gráficos QQ podem ser usados para qualquer distribuição. Se ambos os conjuntos de quantis vieram da mesma distribuição, devemos ver os pontos formando uma linha que é aproximadamente reta.
Num gráfico QQ plot normal os pontos fornecem uma indicação da normalidade do conjunto de dados. Se os dados forem normalmente distribuídos, os pontos cairão na linha de diagonal de 45 graus. Por outro lado, quanto mais os pontos se desviam dessa diagonal, menor a probabilidade de o conjunto de dados seguir uma distribuição normal.
O código abaixo mostra como fazer um gráfico Q-Q plot no R. Primeiro, geramos um conjunto de dados que segue uma distribuição normal e, em seguida, fazemos o gráfico QQ plot normal. Observe como os pontos se aproximam da linha de referência.
# Definindo a semente para reprodutibilidade
set.seed(1)
# Gerando os dados distribuidos de forma normal
dados <- rnorm(100)
# Gráfico Q-Q plot
qqnorm(dados) # Gráfico Q-Q plot
qqline(dados) # Adiciona a linha de referência
Vamos criar agora um conjunto de dados que não segue uma distribuição normal e fazer o gráfico Q-Q plot. Veja como os pontos se desviam da linha de referência.
# Definindo a semente para reprodutibilidade
set.seed(1)

# Gerando os dados distribuidos de forma não normal
dados_nao_normais <- rexp(100, rate = 1)

# Gráfico Q-Q plot
qqnorm(dados_nao_normais) # Gráfico Q-Q plot
qqline(dados_nao_normais) # Adiciona a linha de referência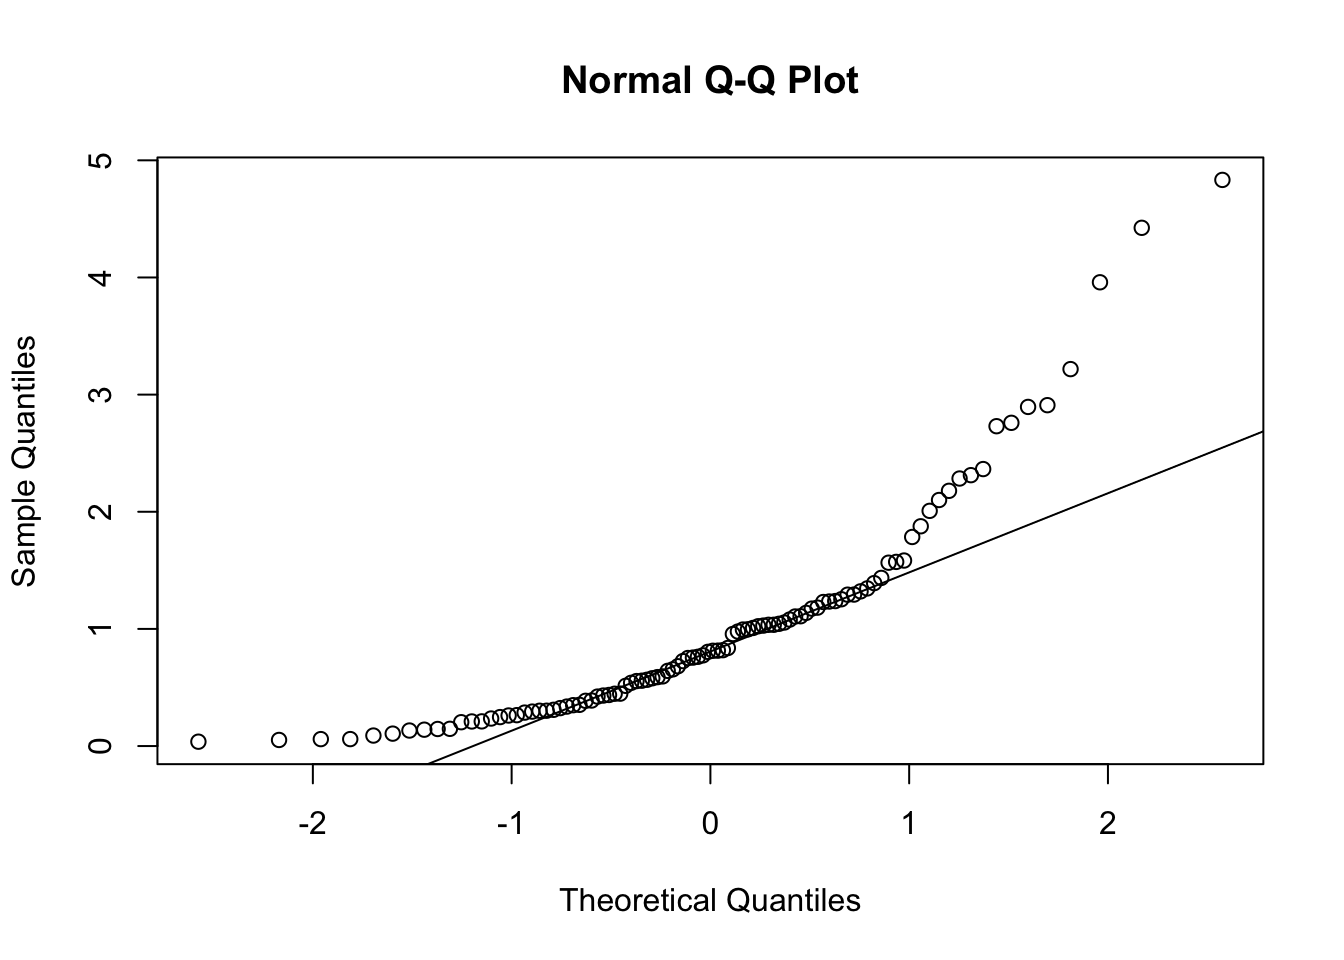
O teste de Shapiro-Wilk é um teste estatístico utilizado para avaliar a normalidade dos dados. A hipótese nula do teste é que os dados seguem uma distribuição normal. Ou sejam, se o valor-p do teste for menor que o nível de significância, a hipótese nula é rejeitada, indicando que os dados não seguem uma distribuição normal. Por outro lado, se o valor-p for maior que o nível de significância, a hipótese nula não é rejeitada, indicando que os dados seguem uma distribuição normal.
O argumento principal do teste de Shapiro-Wilk é o conjunto de dados que queremos testar. O resultado do teste é a estatística \(W\) e o valor-p. \(W\) indica o quão bem os dados se ajustam a uma distribuição normal. O valor \(W\) próximo a 1 indica que os dados provavelmente serão distribuídos normalmente, enquanto um valor significativamente menor que 1 sugere afastamento da normalidade. O valor-p é a probabilidade de obter um valor de W tão extremo quanto o observado, sob a hipótese nula de que os dados seguem uma distribuição normal.
O código abaixo mostra como implementar o teste de Shapiro-Wilk no R. Primeiro, geramos um conjunto de dados que segue uma distribuição normal e, em seguida, fazemos o teste de Shapiro-Wilk. Como já sabemos que nossos dados tem uma distribuição normal, o valor-p desse teste deve ser maior que o nível de significância.
# Definindo a semente para reprodutibilidade
set.seed(1)

# Gerando os dados distribuidos de forma normal
dados <- rnorm(100)

# Teste de Shapiro-Wilk
shapiro.test(dados)
    Shapiro-Wilk normality test

data:  dados
W = 0.9956, p-value = 0.9876
Observe que o valor-p foi realmente maior que o nível de significância, indicando que os dados seguem uma distribuição normal.
Vamos criar agora um conjunto de dados que não segue uma distribuição normal e fazer o teste de Shapiro-Wilk. Observe que o valor-p desse teste deve ser menor que o nível de significância.
# Definindo a semente para reprodutibilidade
set.seed(1)

# Gerando os dados distribuidos de forma não normal
dados_nao_normais <- rexp(100, rate = 1)

# Teste de Shapiro-Wilk
# note que o valor de p do teste de shapiro é mostrado em notação científica
shapiro.test(dados_nao_normais)
    Shapiro-Wilk normality test

data:  dados_nao_normais
W = 0.82218, p-value = 1.263e-09# extraindo o valor de p do teste de shapiro
pvalue=shapiro.test(dados_nao_normais)$p.value
# Imprimindo o valor de p por extenso
print(paste("p-value =", format(pvalue, scientific = FALSE)))[1] "p-value = 0.000000001262599"Como previsto, o valor-p foi menor que o nível de significância, indicando que os dados não seguem uma distribuição normal.
O teste de Kolmogorov-Smirnov é um outro teste estatístico utilizado para avaliar a normalidade dos dados. Da mesma forma que o teste de Shapiro-Wilki, a hipótese nula do teste de de Kolmogorov-Smirnov é que os dados seguem uma distribuição normal. Ou sejam, se o valor-p do teste for menor que o nível de significância, a hipótese nula é rejeitada, indicando que os dados não seguem uma distribuição normal. Por outro lado, se o valor-p for maior que o nível de significância, a hipótese nula não é rejeitada, indicando que os dados seguem uma distribuição normal.
O teste te Kolmorov-Smirnov também pode ser usado para testar se os dados vem de outras distribuições, pois o teste na verdade verifica se duas distribuições são iguais, ou seja, se uma amostra vem de uma distribuição em particular. Quando desejamos saber se a amostra tem uma distribuiçao normal, o teste de Kolmogorov-Smirnov compara a distribuição empírica dos dados com a distribuição teórica normal.
O argumento principal do teste de Kolmogorov-Smirnov também é o conjunto de dados que queremos testar. Mas também precisamos especificar a distribuição teórica que queremos testar. No nosso caso isso será feito com a string “pnorm”, que indica que queremos testar se os dados seguem uma distribuição normal. Além disso precisamos também especificar os parâmetros da distribuição teórica, que no caso da distribuição normal são a média e o desvio padrão. O mais indicado é usar a média e o desvio padrão dos dados, como fizemos no exemplo abaixo.
O resultado do teste é a estatística \(D\) e o valor-p. \(D\) é a maior diferença entre a função de distribuição acumulada empírica dos dados e a função de distribuição acumulada teórica. O valor-p é a probabilidade de obter um valor de \(D\) tão extremo quanto o observado, sob a hipótese nula de que os dados seguem uma distribuição normal.
O código abaixo mostra como implementar o teste de Kolmogorov-Smirnov no R. Primeiro, geramos um conjunto de dados que segue uma distribuição normal e, em seguida, fazemos o teste de Kolmogorov-Smirnov. Como já sabemos que nossos dados tem uma distribuição normal, o valor-p desse teste deve ser maior que o nível de significância.
# Definindo a semente para reprodutibilidade
set.seed(1)

# Gerando os dados distribuidos de forma normal
dados <- rnorm(100)

# Teste de Kolmogorov-Smirnov
ks.test(dados, "pnorm", mean = mean(dados), sd = sd(dados))
    Asymptotic one-sample Kolmogorov-Smirnov test

data:  dados
D = 0.047014, p-value = 0.9799
alternative hypothesis: two-sided
Observe que o valor de p foi realmente maior que o nível de significância, indicando que os dados seguem uma distribuição normal.
Vamos criar agora um conjunto de dados que não segue uma distribuição normal e fazer o teste de Kolmogorov-Smirnov. Observe que o valor-p desse teste deve ser menor que o nível de significância.
# Definindo a semente para reprodutibilidade
set.seed(1)

# Gerando os dados distribuidos de forma não normal
dados_nao_normais <- rexp(100, rate = 1)

# Teste de Kolmogorov-Smirnov
ks.test(dados_nao_normais, "pnorm", mean = mean(dados_nao_normais), sd = sd(dados_nao_normais))
    Asymptotic one-sample Kolmogorov-Smirnov test

data:  dados_nao_normais
D = 0.15964, p-value = 0.01223
alternative hypothesis: two-sided
Observe que o valor-p foi menor que o nível de significância, indicando que os dados não seguem uma distribuição normal.