Code
# Carregar os pacotes necessários
library(dplyr)    # Manipulação de dados
library(tidyr)    # Funções para "arrumar" dados
library(stringr)  # Manipulação de strings
library(janitor)  # Limpeza de dados
library(skimr)Nesta aula, vamos explorar as etapas fundamentais da limpeza de dados usando a linguagem R. Aprenderemos a identificar e tratar problemas comuns em datasets, como valores ausentes, duplicados, erros de formatação, outliers e inconsistências nos dados. A limpeza de dados é um passo crucial para garantir que as análises sejam precisas e confiáveis.
Vamos começar carregando os pacotes necessários que facilitam a manipulação e limpeza de dados:
# Carregar os pacotes necessários
library(dplyr) # Manipulação de dados
library(tidyr) # Funções para "arrumar" dados
library(stringr) # Manipulação de strings
library(janitor) # Limpeza de dados
library(skimr)Para praticarmos, vamos criar um dataset fictício que simula diversos problemas de dados, como valores ausentes, duplicatas, erros de formatação e outliers:
# Criando um DataFrame com problemas
dados <- data.frame(
  ID = c(1, 2, 2, 4, 5, NA, 7, 8, 9, 10, 11),                                   # IDs com duplicatas e valores ausentes
  nome = c("Ana", "Carlos", "Carlos", "bruno", "Daniel",
           "Fernando", NA, "Gustavo", "Helena", "isabela", "Antônio"),          # nomes com valores ausentes e capitlização inadequada.
  sexo = c(0, 1, 1, 1, 1, 1, 0, 1, 0, 0, 1),
  idade = c(23, 35, 35, 40, NA, 28, 32, -5, 30, 45, 158),                        # idade com valores negativos e ausentes
  peso = c(65, 85, 85, 78, 90, 88, 58, 82, 62, 70, 95),                          # Peso em kg
  altura = c(1.65, 1.78, 1.78, 1.75, 1.80, 1.82, 1.60, 1.77, 1.68, 1.72, 1.85),  # Altura em metros
  salario = c(5000, 7000, 7000, 6500, 0, 7200, 6800, 7100,
              7500, 8000, 1000),                                                 # Salários com valores zero (inconsistência) e salário muito alto
  departamento = c("Vendas", "Vendas", "Vendas", "RH",
                   "RH", NA, "TI", "TI", "TI", "Administração", "RH")             # departamentos com valores ausentes
)

# Exibindo o DataFrame
print(dados)
ID nome sexo idade peso altura salario departamento
1 1 Ana 0 23 65 1.65 5000 Vendas
2 2 Carlos 1 35 85 1.78 7000 Vendas
3 2 Carlos 1 35 85 1.78 7000 Vendas
4 4 bruno 1 40 78 1.75 6500 RH
5 5 Daniel 1 NA 90 1.80 0 RH
6 NA Fernando 1 28 88 1.82 7200 <NA>
7 7 <NA> 0 32 58 1.60 6800 TI
8 8 Gustavo 1 -5 82 1.77 7100 TI
9 9 Helena 0 30 62 1.68 7500 TI
10 10 isabela 0 45 70 1.72 8000 Administração
11 11 Antônio 1 158 95 1.85 1000 RHA análise exploratória dos dados (EDA) é uma etapa crucial em qualquer projeto de ciência de dados, especialmente na área da saúde, onde decisões clínicas podem ser influenciadas pela qualidade da análise. A EDA permite ao pesquisador entender a estrutura, as características principais e as peculiaridades dos dados antes de aplicar métodos estatísticos mais avançados. No contexto da linguagem R, ferramentas simples como as funções str(), head() e tail() são essenciais para essa análise inicial.
A função str() fornece uma visão geral da estrutura dos dados, mostrando o tipo de cada variável e os primeiros elementos de cada coluna. Isso ajuda a identificar possíveis inconsistências, como tipos de dados incorretos ou valores ausentes. As funções head() e tail() complementam essa análise ao exibir as primeiras e últimas linhas do conjunto de dados, permitindo ao usuário uma inspeção mais detalhada dos valores presentes.
Além dessas funções, a realização de algumas visualizações iniciais, como gráficos com plot() ou boxplots, é fundamental para identificar outliers, assimetrias e tendências nos dados. Por exemplo, um boxplot pode revelar a presença de valores extremos que poderiam influenciar significativamente os resultados de uma análise estatística.
O uso do RStudio facilita todo esse processo, integrando a análise de dados e a criação de visualizações em um ambiente interativo, onde o pesquisador pode iterar rapidamente entre a inspeção dos dados e a geração de gráficos. Dessa forma, a análise exploratória se torna um passo indispensável para garantir a qualidade e a robustez das conclusões obtidas nas etapas subsequentes da análise de dados.
str(dados)'data.frame': 11 obs. of 8 variables:
$ ID : num 1 2 2 4 5 NA 7 8 9 10 ...
$ nome : chr "Ana" "Carlos" "Carlos" "bruno" ...
$ sexo : num 0 1 1 1 1 1 0 1 0 0 ...
$ idade : num 23 35 35 40 NA 28 32 -5 30 45 ...
$ peso : num 65 85 85 78 90 88 58 82 62 70 ...
$ altura : num 1.65 1.78 1.78 1.75 1.8 1.82 1.6 1.77 1.68 1.72 ...
$ salario : num 5000 7000 7000 6500 0 7200 6800 7100 7500 8000 ...
$ departamento: chr "Vendas" "Vendas" "Vendas" "RH" ...Aqui podemos ver que o R entendeu o sexo como uma variável numérica. Será necessário ajustar isso, transformando essa variável em factor. Será também útil transformar a variável departamento em factor.
# Transformando a variável 'sexo' em um factor usando dplyr
dados <- dados |>
              mutate(sexo = recode_factor(sexo, `0` = "Feminino",
                                                `1` = "Masculino"))

# Transformando a variável 'departamento' em um factor usando dplyr
dados <- dados |>
              mutate(departamento = factor(departamento))


# Verificando o resultado
str(dados)
'data.frame': 11 obs. of 8 variables:
$ ID : num 1 2 2 4 5 NA 7 8 9 10 ...
$ nome : chr "Ana" "Carlos" "Carlos" "bruno" ...
$ sexo : Factor w/ 2 levels "Feminino","Masculino": 1 2 2 2 2 2 1 2 1 1 ...
$ idade : num 23 35 35 40 NA 28 32 -5 30 45 ...
$ peso : num 65 85 85 78 90 88 58 82 62 70 ...
$ altura : num 1.65 1.78 1.78 1.75 1.8 1.82 1.6 1.77 1.68 1.72 ...
$ salario : num 5000 7000 7000 6500 0 7200 6800 7100 7500 8000 ...
$ departamento: Factor w/ 4 levels "Administração",..: 4 4 4 2 2 NA 3 3 3 1 ...head(dados) ID nome sexo idade peso altura salario departamento
1 1 Ana Feminino 23 65 1.65 5000 Vendas
2 2 Carlos Masculino 35 85 1.78 7000 Vendas
3 2 Carlos Masculino 35 85 1.78 7000 Vendas
4 4 bruno Masculino 40 78 1.75 6500 RH
5 5 Daniel Masculino NA 90 1.80 0 RH
6 NA Fernando Masculino 28 88 1.82 7200 <NA>tail(dados) ID nome sexo idade peso altura salario departamento
6 NA Fernando Masculino 28 88 1.82 7200 <NA>
7 7 <NA> Feminino 32 58 1.60 6800 TI
8 8 Gustavo Masculino -5 82 1.77 7100 TI
9 9 Helena Feminino 30 62 1.68 7500 TI
10 10 isabela Feminino 45 70 1.72 8000 Administração
11 11 Antônio Masculino 158 95 1.85 1000 RHboxplot(dados$idade)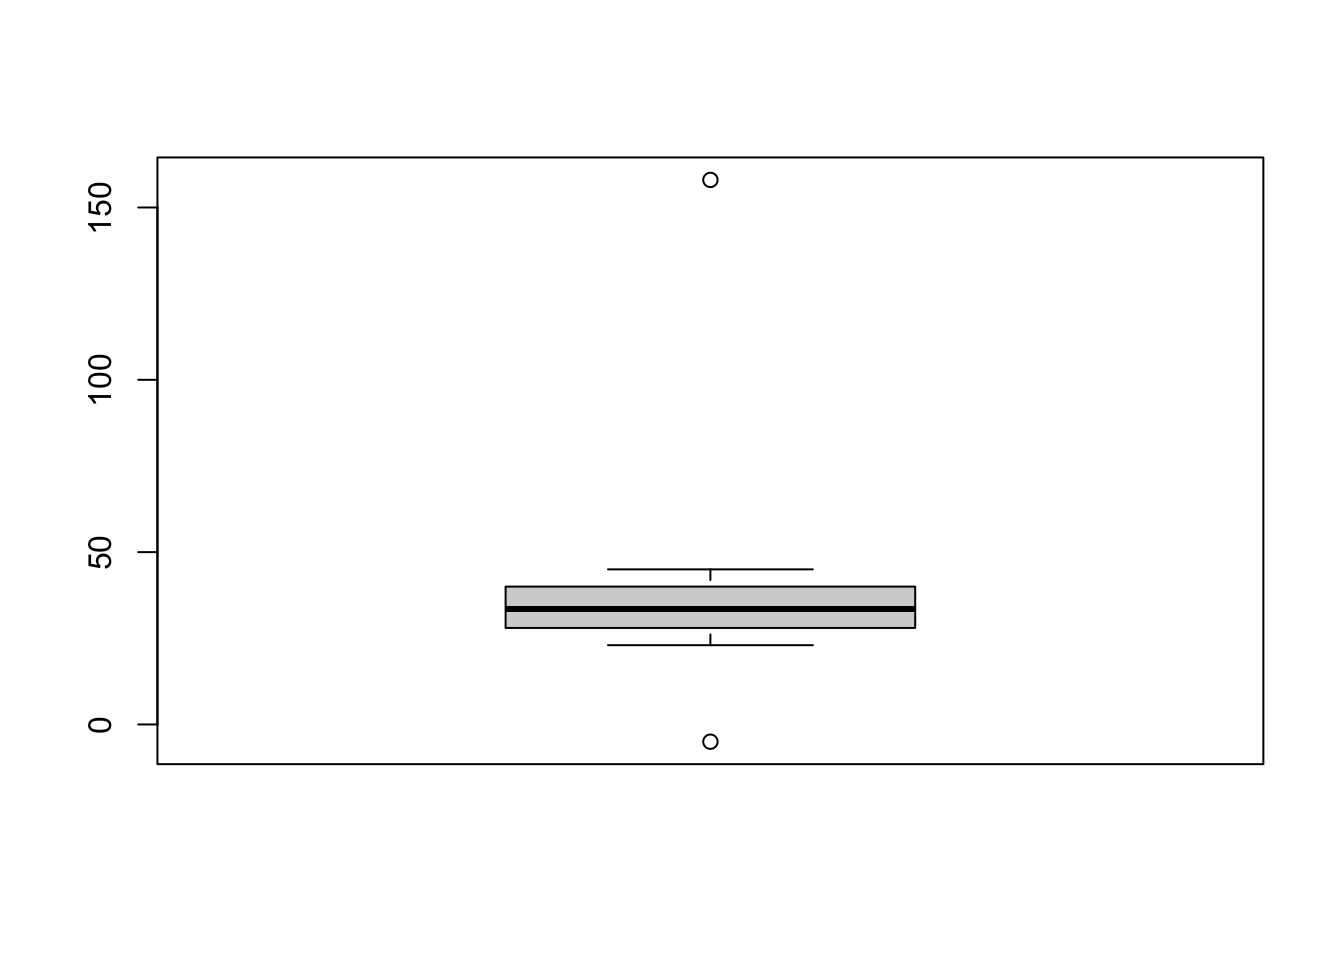
O Boxplot mostra haver valores muito extremos para a idade, evidenciando alguma inconsistência ou erro, pois é improvável haver um funcionario com 150 anos de idade.
boxplot(peso~sexo, dados)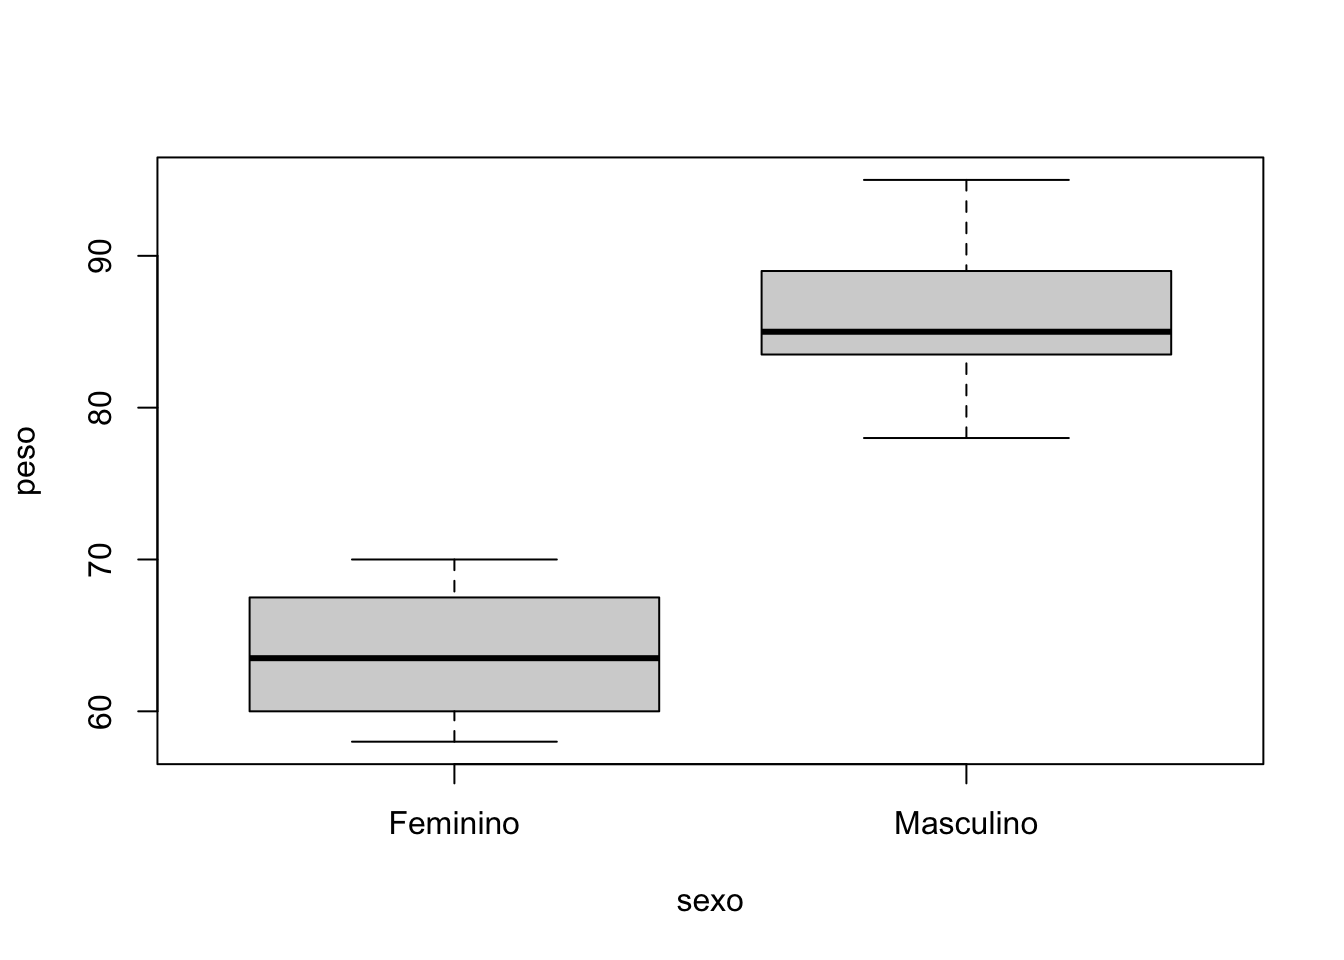
plot(dados$altura, dados$peso)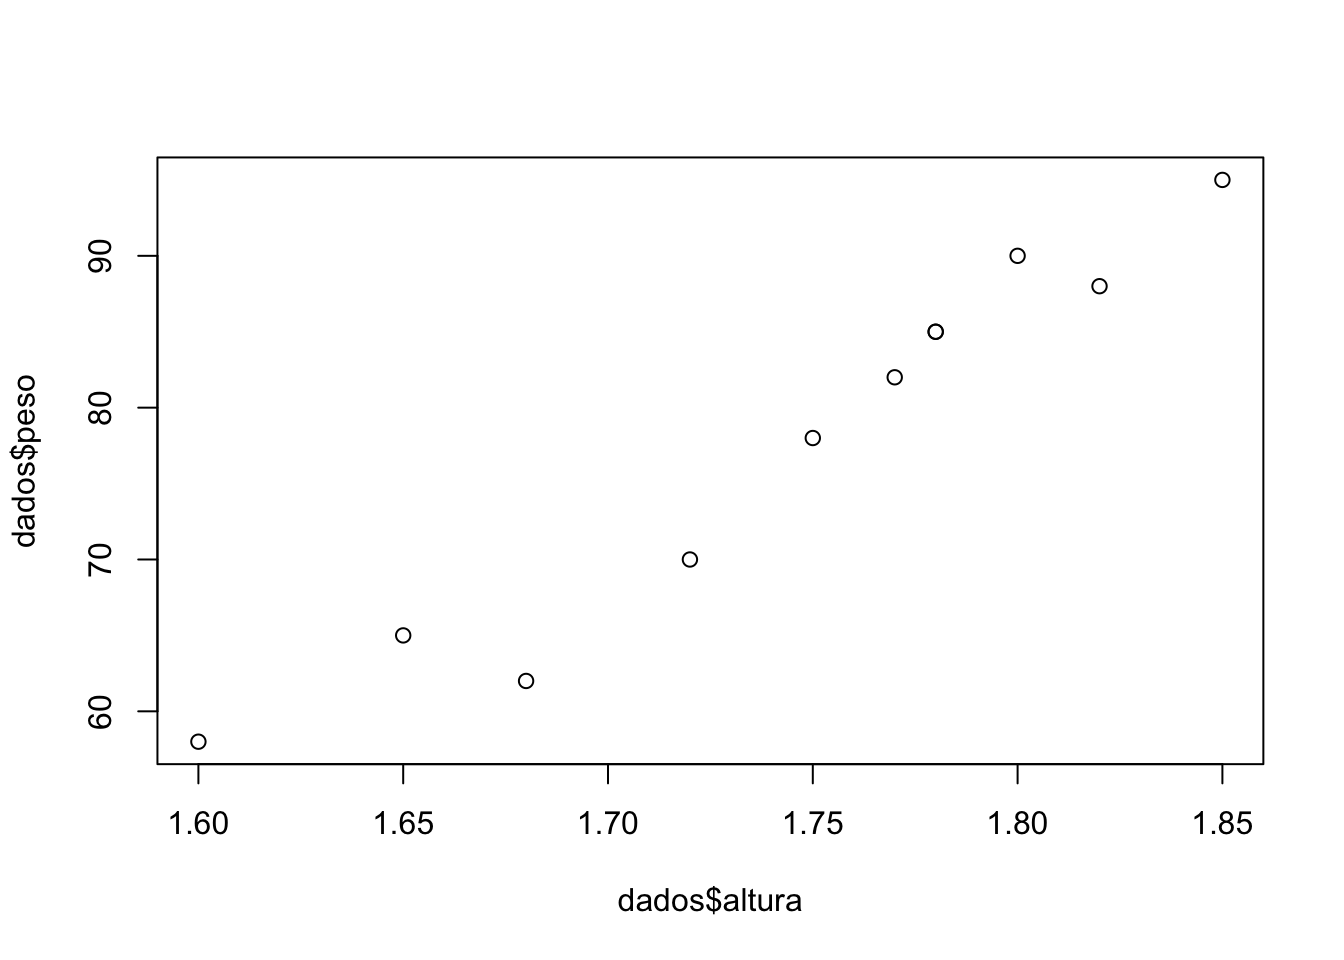
Identificação de valores ausentes: Um passo importante é verificar se existem valores ausentes (NAs) no dataset. A função is.na() retorna TRUE para os valores que estão ausentes.
# Verificando valores ausentes com a função skim do pacote skimr
skim(dados)| Name | dados |
| Number of rows | 11 |
| Number of columns | 8 |
| _______________________ | |
| Column type frequency: | |
| character | 1 |
| factor | 2 |
| numeric | 5 |
| ________________________ | |
| Group variables | None |
Variable type: character
| skim_variable | n_missing | complete_rate | min | max | empty | n_unique | whitespace |
|---|---|---|---|---|---|---|---|
| nome | 1 | 0.91 | 3 | 8 | 0 | 9 | 0 |
Variable type: factor
| skim_variable | n_missing | complete_rate | ordered | n_unique | top_counts |
|---|---|---|---|---|---|
| sexo | 0 | 1.00 | FALSE | 2 | Mas: 7, Fem: 4 |
| departamento | 1 | 0.91 | FALSE | 4 | RH: 3, TI: 3, Ven: 3, Adm: 1 |
Variable type: numeric
| skim_variable | n_missing | complete_rate | mean | sd | p0 | p25 | p50 | p75 | p100 | hist |
|---|---|---|---|---|---|---|---|---|---|---|
| ID | 1 | 0.91 | 5.90 | 3.60 | 1.0 | 2.5 | 6.00 | 8.75 | 11.00 | ▇▅▂▅▅ |
| idade | 1 | 0.91 | 42.10 | 42.92 | -5.0 | 28.5 | 33.50 | 38.75 | 158.00 | ▂▇▁▁▁ |
| peso | 0 | 1.00 | 78.00 | 12.39 | 58.0 | 67.5 | 82.00 | 86.50 | 95.00 | ▇▂▂▇▇ |
| altura | 0 | 1.00 | 1.75 | 0.08 | 1.6 | 1.7 | 1.77 | 1.79 | 1.85 | ▃▂▃▇▃ |
| salario | 0 | 1.00 | 5736.36 | 2702.32 | 0.0 | 5750.0 | 7000.00 | 7150.00 | 8000.00 | ▂▁▁▁▇ |
Tratamento de valores ausentes: Existem várias abordagens para lidar com valores ausentes:
na.omit() remove qualquer linha que contenha um NA.# Remover linhas com valores ausentes
dados_limpos <- na.omit(dados)
dados_limpos ID nome sexo idade peso altura salario departamento
1 1 Ana Feminino 23 65 1.65 5000 Vendas
2 2 Carlos Masculino 35 85 1.78 7000 Vendas
3 2 Carlos Masculino 35 85 1.78 7000 Vendas
4 4 bruno Masculino 40 78 1.75 6500 RH
8 8 Gustavo Masculino -5 82 1.77 7100 TI
9 9 Helena Feminino 30 62 1.68 7500 TI
10 10 isabela Feminino 45 70 1.72 8000 Administração
11 11 Antônio Masculino 158 95 1.85 1000 RHmean() pode calcular a média ignorando NAs com o parâmetro na.rm = TRUE.# Calculando a média da idade desconsiderando os valores ausentes
mediaIdade <- mean(dados$idade, na.rm = TRUE)
# Substituir valores ausentes pela média (no caso da coluna idade)
dados <- dados %>%
mutate(idade = replace_na(idade, mediaIdade))Identificação de duplicatas: A função duplicated() identifica linhas duplicadas, retornando TRUE para a segunda ocorrência em diante.
# Identificando duplicatas usando tidyverse
dados |>
  filter(duplicated(across(everything())))
ID nome sexo idade peso altura salario departamento
1 2 Carlos Masculino 35 85 1.78 7000 Vendas# Usando a função get_dupes do pacote janitor para identificar duplicatas o código fica bem mais simples
dados |>
get_dupes()No variable names specified - using all columns. ID nome sexo idade peso altura salario departamento dupe_count
1 2 Carlos Masculino 35 85 1.78 7000 Vendas 2
2 2 Carlos Masculino 35 85 1.78 7000 Vendas 2Remoção de duplicatas: A função distinct() do pacote dplyr remove duplicatas, mantendo apenas a primeira ocorrência.
# Remover duplicatas
dados_limpos <- distinct(dados)Padronização de formatação: O pacote stringr oferece várias funções para manipular strings. A função str_to_title() converte strings para “Title Case”, onde a primeira letra de cada palavra é maiúscula. Categorias inconsistentes em variáveis categóricas podem ser padronizadas com str_to_title() para garantir que todas as entradas tenham o mesmo formato.
# Padronizar texto (nomes em "Title Case") com a função str_to_title() do pacote stringr
dados$nome <- str_to_title(dados$nome)# Padronizar categorias na coluna departamento
dados <- dados %>%
mutate(departamento = str_to_title(departamento))Conversão de tipos de dados: Às vezes, dados numéricos podem ser armazenados como texto ou vice-versa. A função as.numeric() converte strings ou fatores para números.
# Conversão do ID para numérico
dados$ID <- as.numeric(dados$ID)Identificação de outliers: Outliers podem ser identificados visualmente usando um boxplot. A função boxplot() é útil para isso.
# Identificação de outliers com boxplot
boxplot(dados$idade, main = "Boxplot da idade")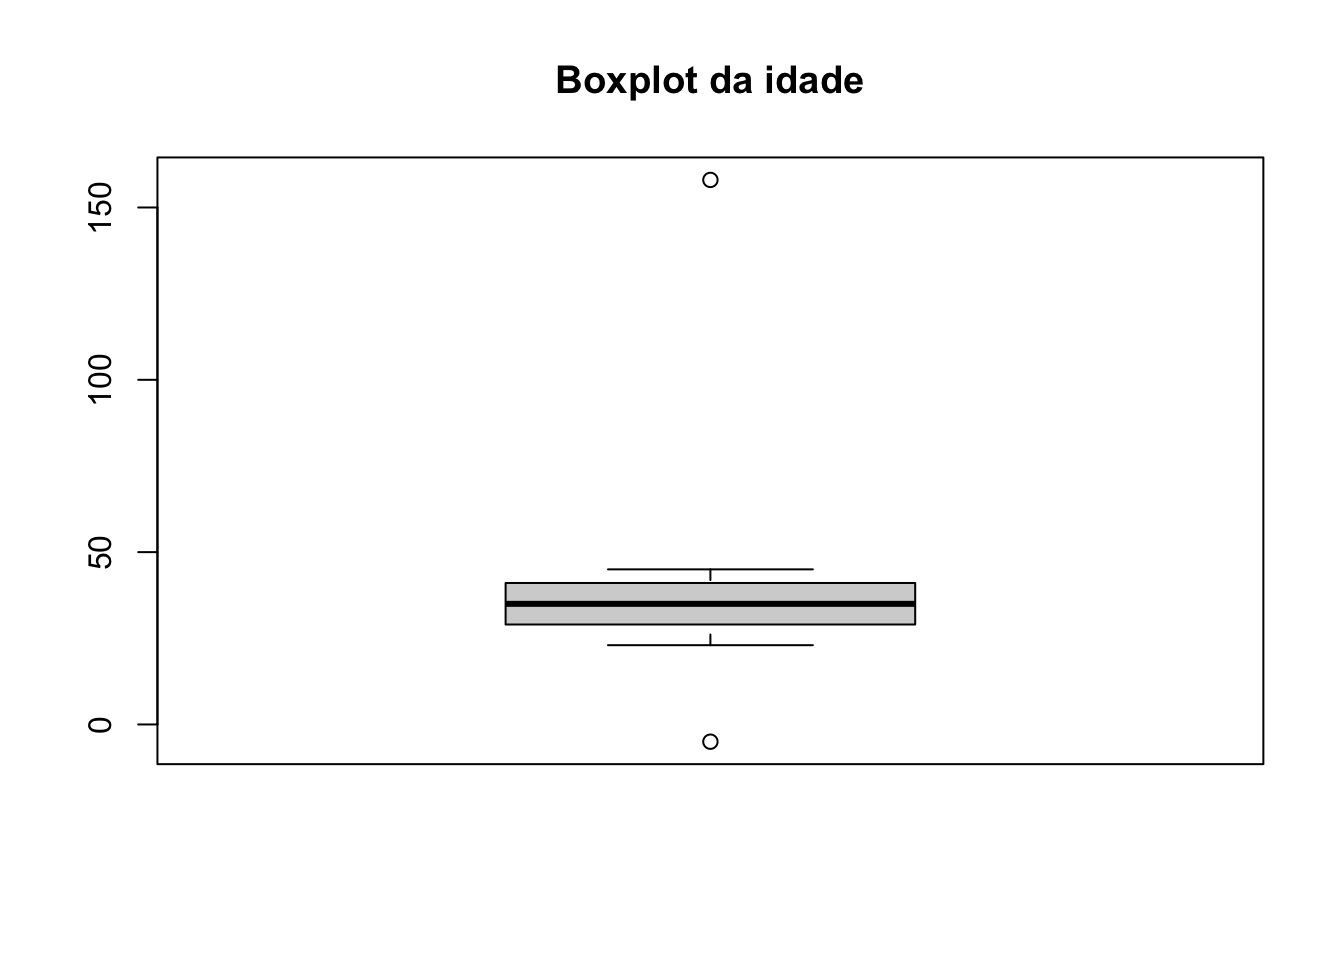
Tratamento de outliers: Podemos substituir ou remover outliers. No exemplo abaixo, valores negativos na coluna idade são substituídos por NA.
# Tratamento de outliers (Substituir valores negativos na idade)
dados <- dados |>
            mutate(idade = ifelse(idade < 0, NA, idade))
A função ifelse() é usada para executar verificações condicionais em vetores. idade < 0 é a condição que está sendo verificada. Ela testa se o valor de idade é menor que 0. NA é o valor que será atribuído a idade se a condição for verdadeira (ou seja, se idade for menor que 0). Isso substitui valores negativos de idade por NA, que em R é utilizado para representar valores ausentes ou “Not Available”. idade é o valor que será mantido se a condição for falsa (ou seja, se idade não for menor que 0). Neste caso, a idade original é mantida sem alteração.
Verificação de regras de negócio: Filtrar dados que não atendem a certas condições. Por exemplo, salários que não podem ser zero ou negativos.
# Remover registros com salário zero ou negativo
dados <- dados |>
  filter(salario > 0)